Spare Thumbs : Gemma 4 répond à « on peut déplacer la réunion? » avec mes mots, à partir de mon vrai agenda, sans jamais me surbooker
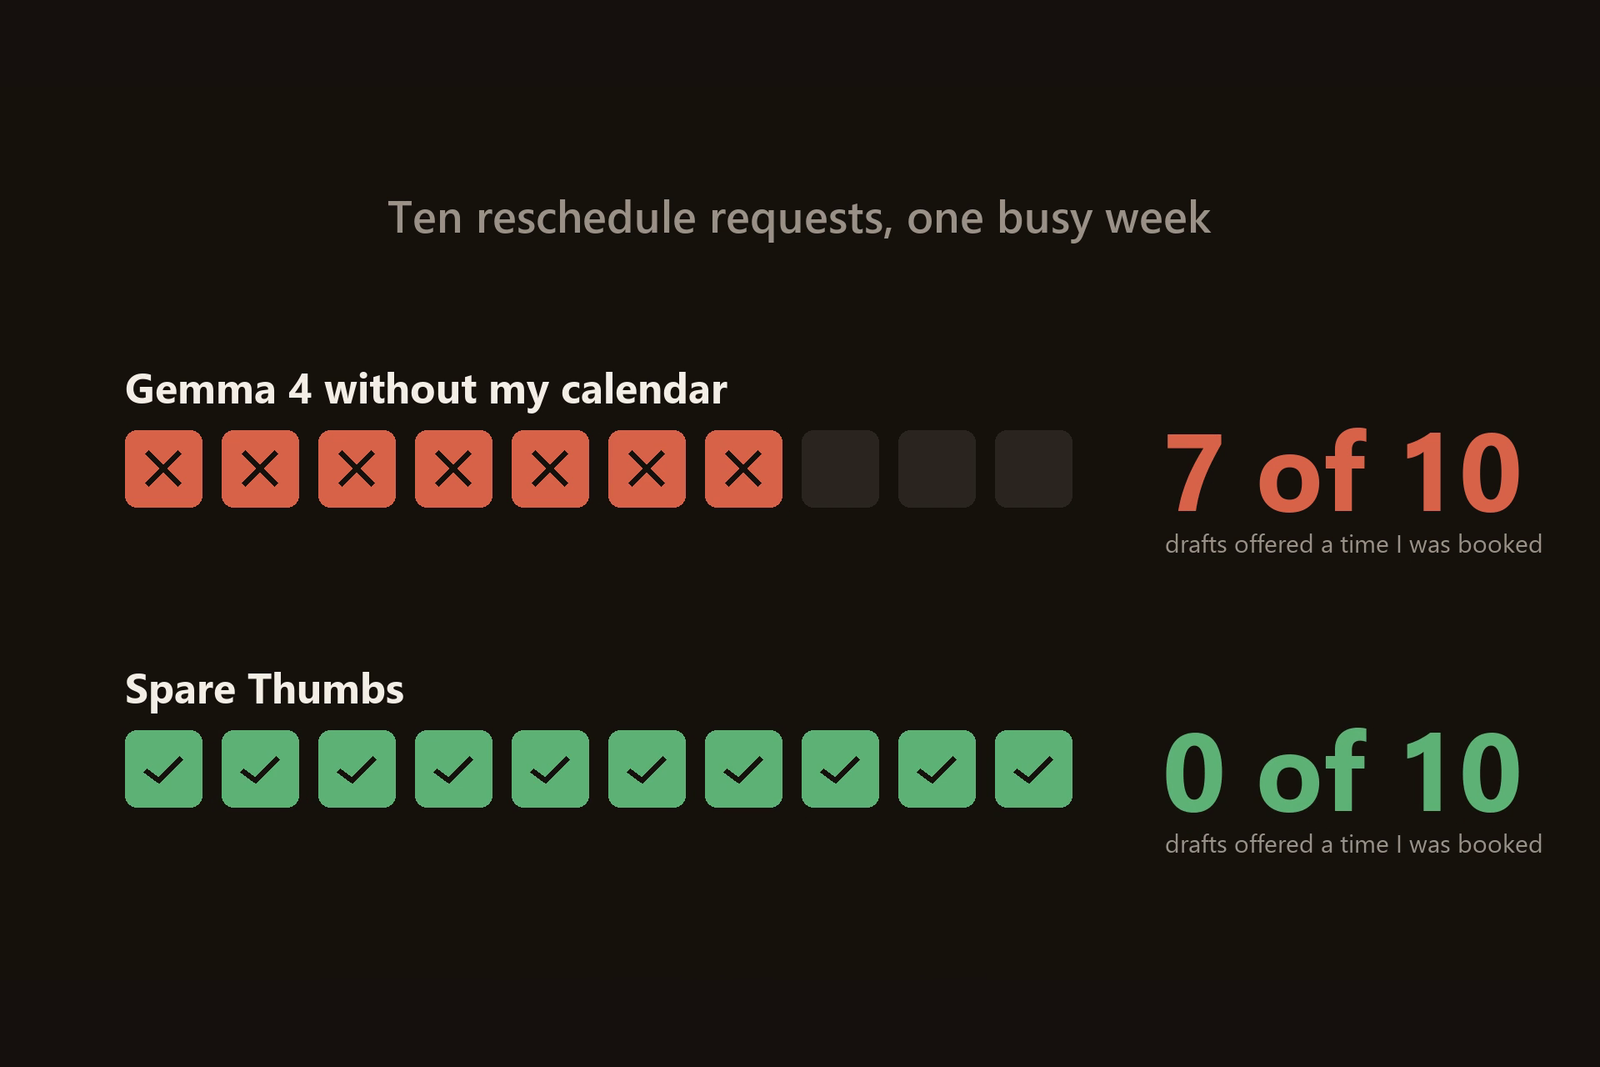
Les clients déplacent leurs réunions le soir. Spare Thumbs, c'est Gemma 4 sur mon portable : il lit la demande dans Gmail, vérifie mon vrai Google Agenda, rédige la réponse avec mes mots et déplace l'événement quand le client confirme. Sur dix demandes dans une semaine chargée, Gemma 4 seul a proposé une heure prise dans 7 brouillons; Spare Thumbs, dans 0.
Les clients déplacent leurs réunions le soir
« Il y a un imprévu jeudi, on pourrait faire vendredi 10 h à la place? » Pour répondre, j'ouvre mon agenda, je trouve un trou et je tape la même réponse que d'habitude. Ça arrive à peu près une fois par semaine, par courriel, WhatsApp et Discord, et ça coûte environ cinq minutes chaque fois : la réponse, puis revenir pour la confirmation et déplacer l'événement.
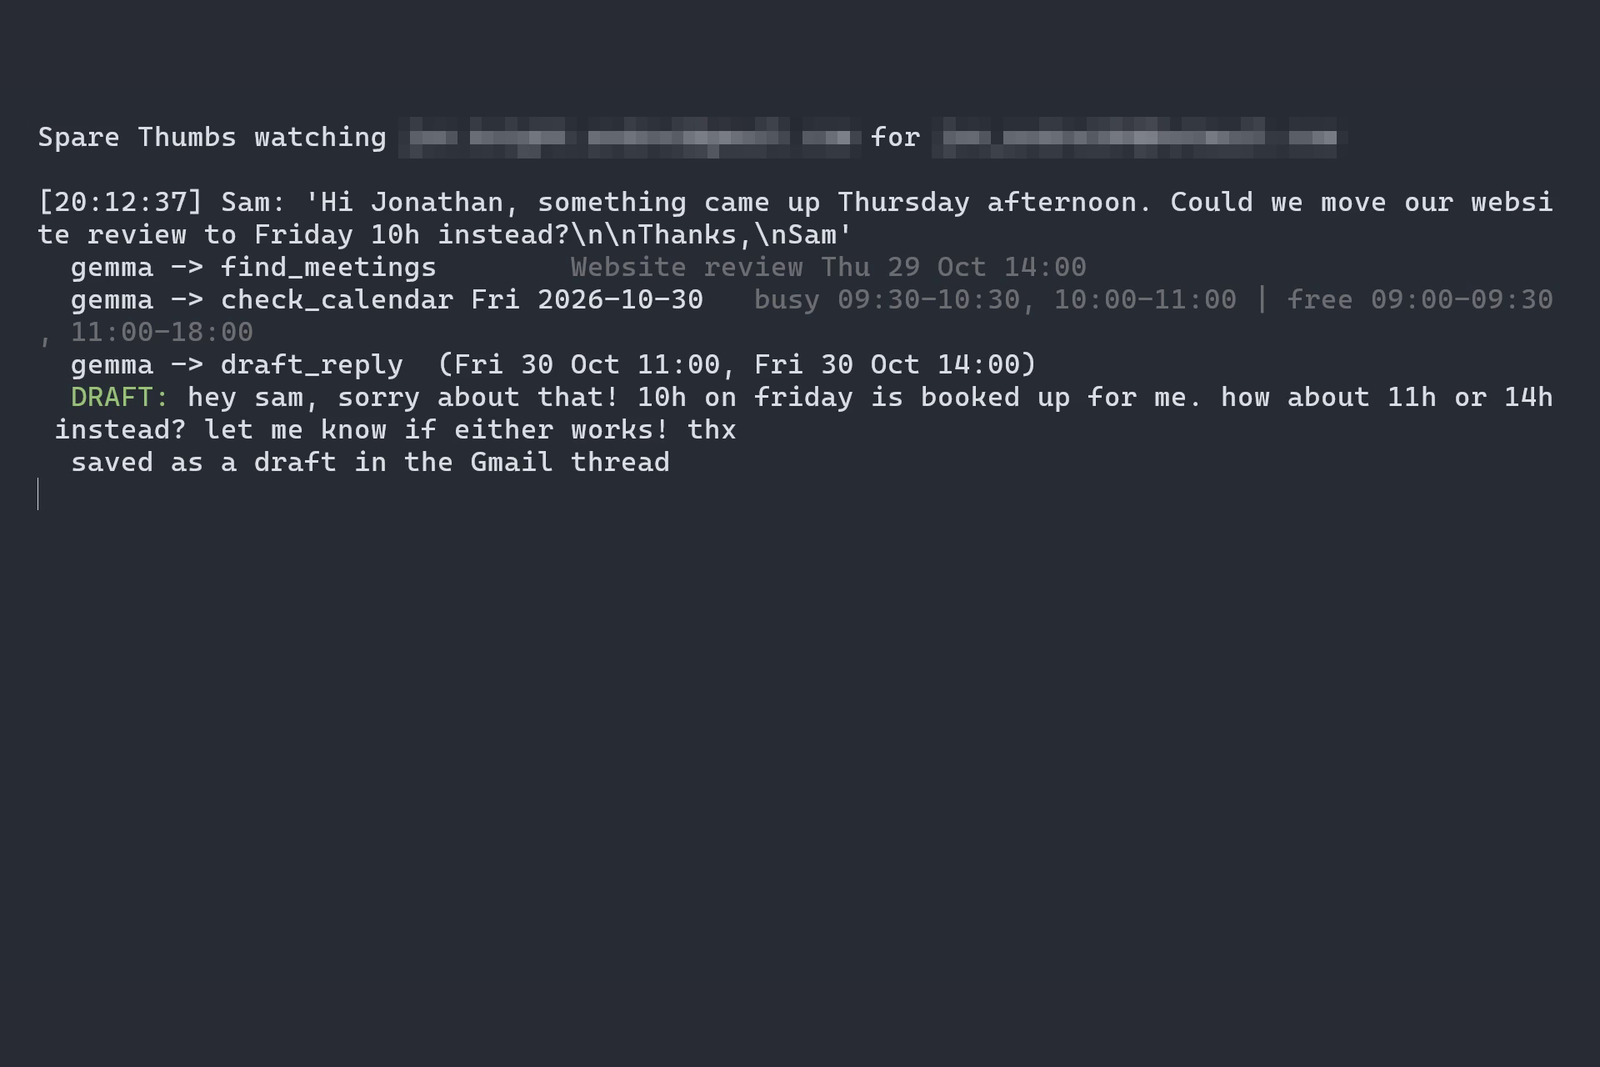
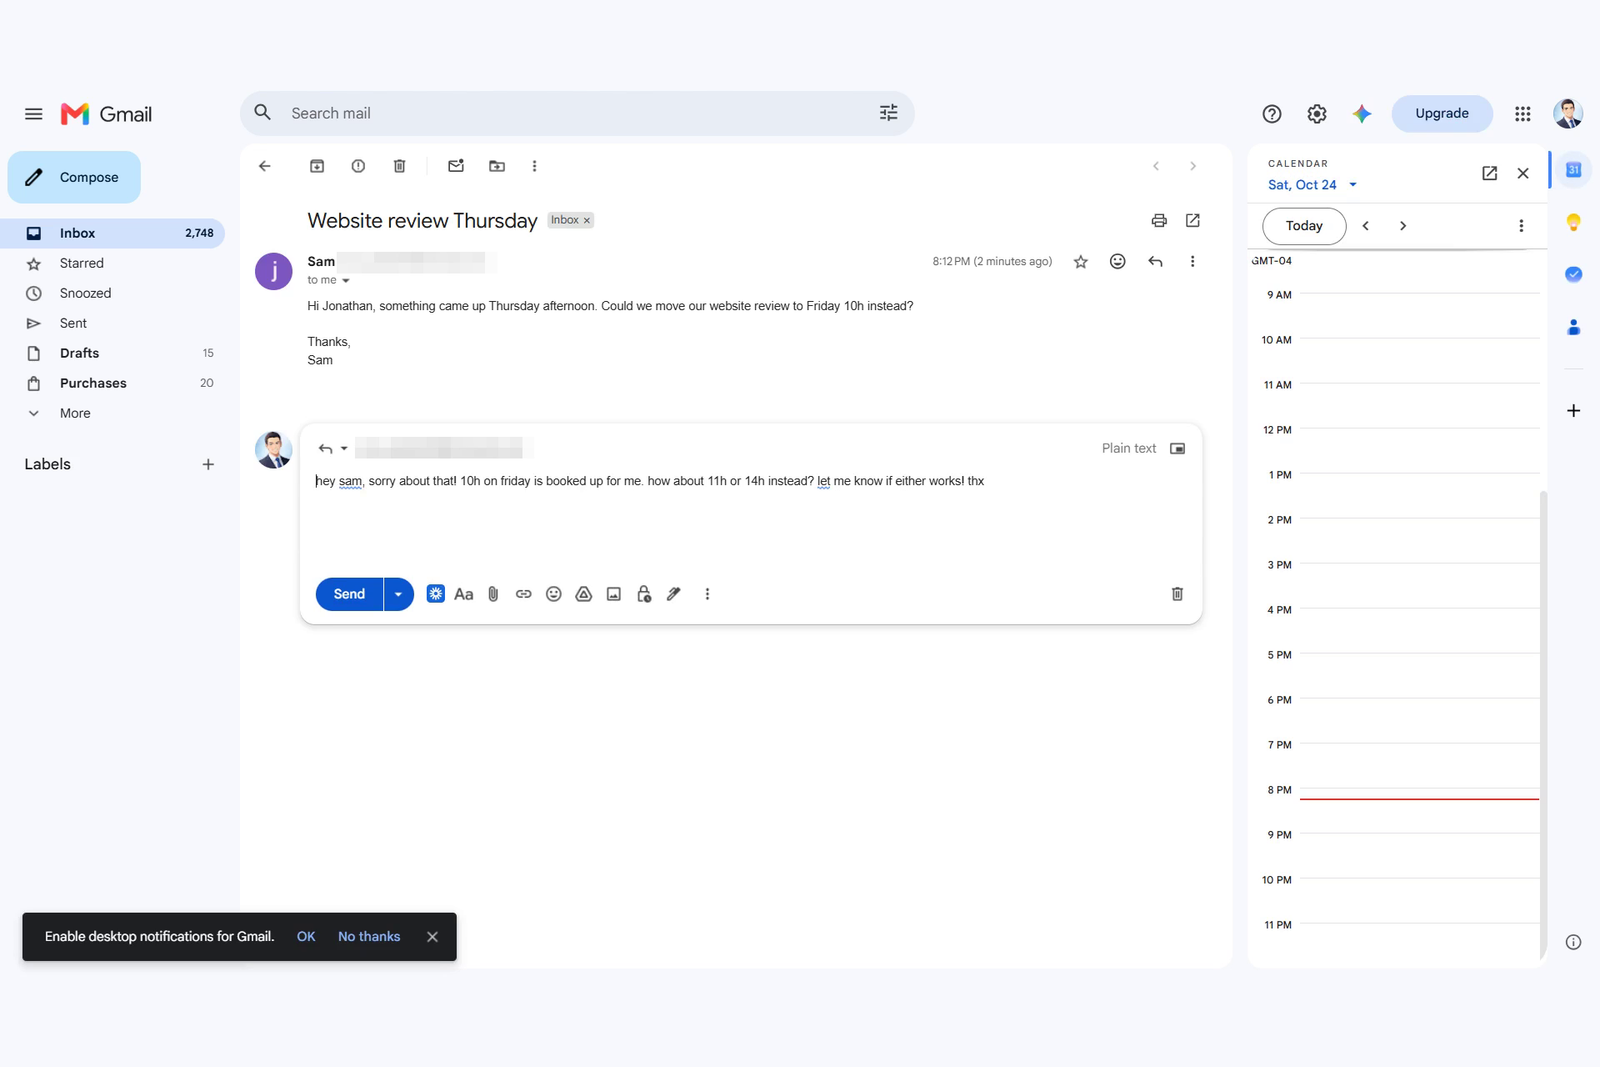
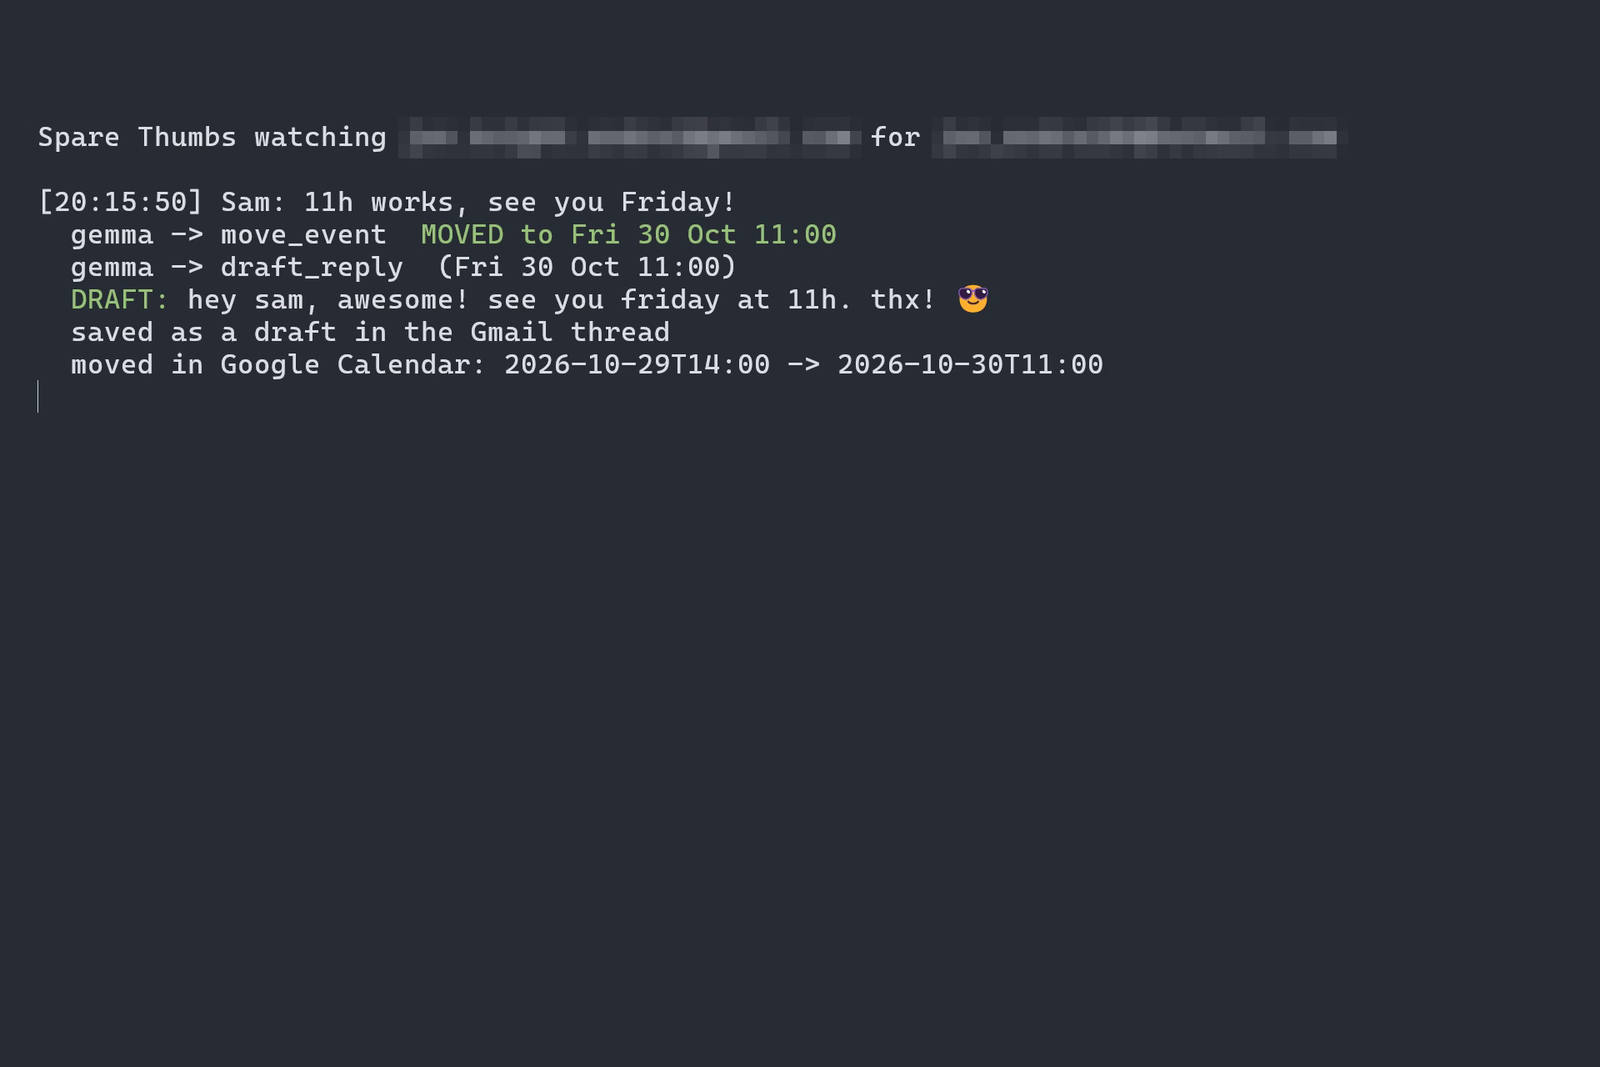
Spare Thumbs répond à ma place. Gemma 4 tourne sur mon portable et surveille mon Gmail. Quand un client demande de déplacer une réunion, il trouve la réunion, vérifie mon vrai Google Agenda et laisse une réponse en brouillon dans le fil Gmail. Si l'heure demandée est libre, il dit oui. Sinon, il propose des heures où je suis vraiment libre. Quand le client écrit « 11 h, ça marche », il déplace l'événement et rédige la confirmation. La partie paresseuse : j'appuie sur Envoyer.
Gemma 4 décide de chaque étape
gemma4:e4b tourne avec Ollama, avec l'appel de fonctions natif et cinq outils : find_meetings, check_calendar, draft_reply, move_event et hand_off. Pour chaque nouveau message, il choisit quel jour vérifier, lit ce qui est réservé, puis accepte, propose d'autres heures, pose une question ou me laisse le message. Quand le client répond, la même boucle repart avec ce qu'il avait proposé, et il choisit de déplacer l'événement et de confirmer. La boucle se termine quand Gemma arrête d'appeler des outils.
Ma voix, sans réentraînement
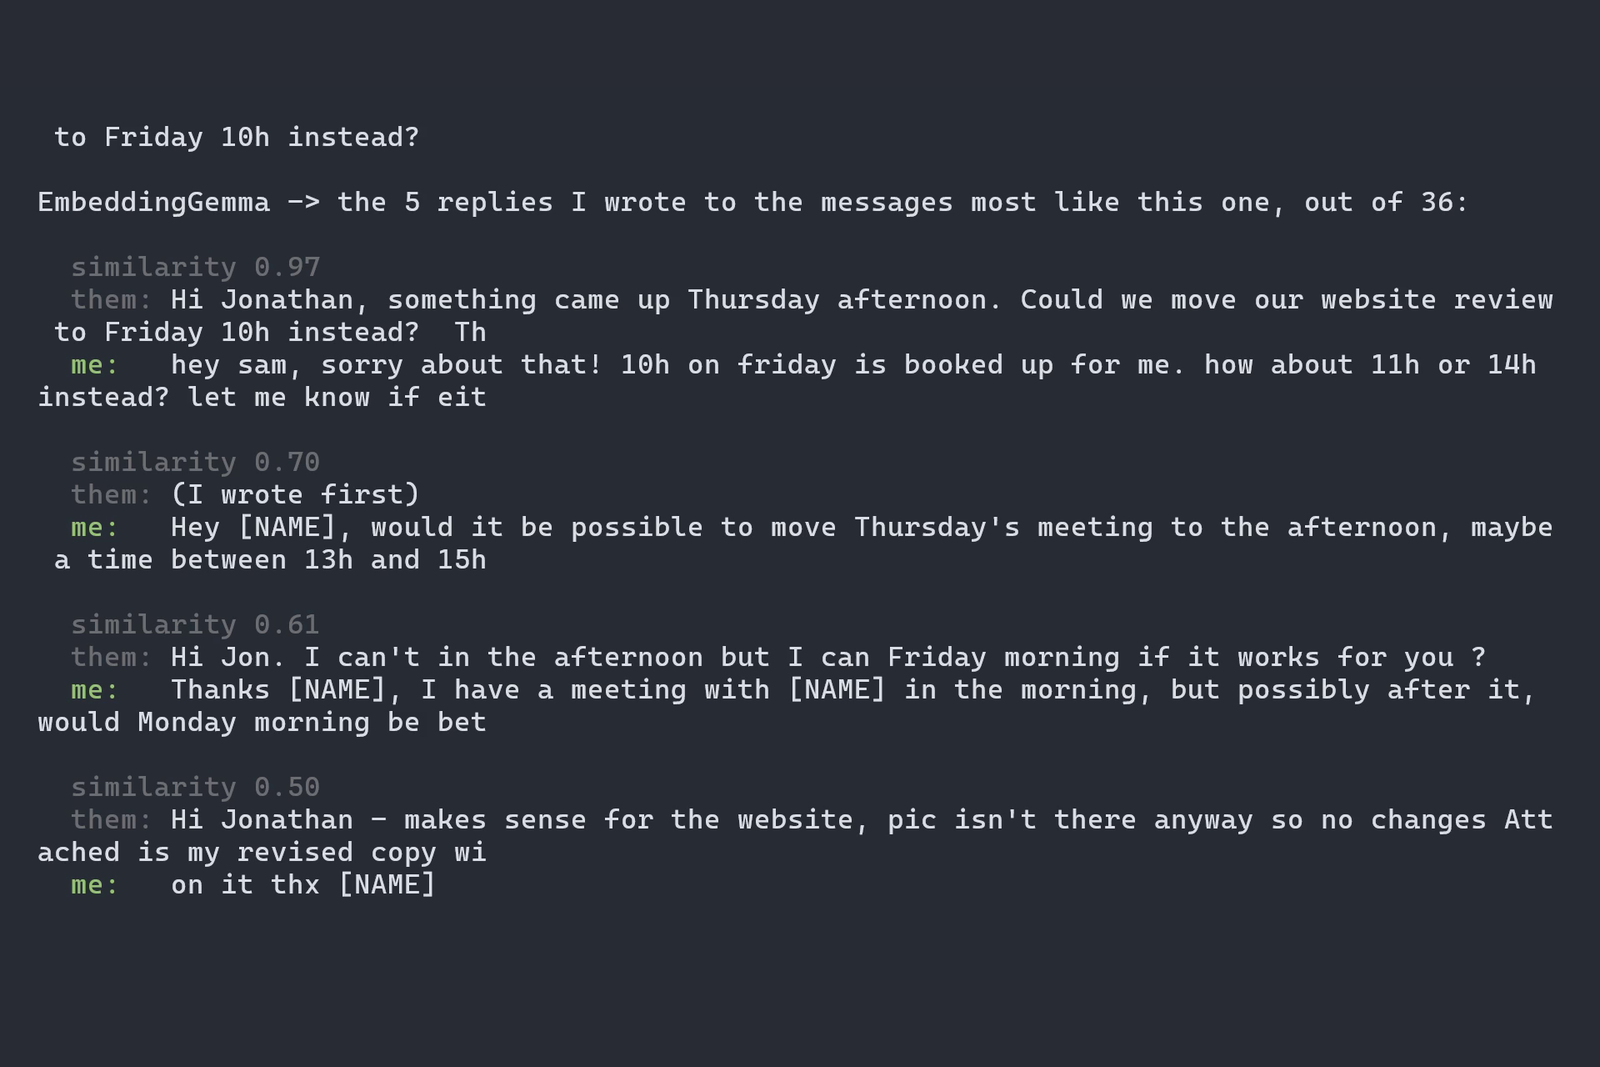
J'ai 63 messages à moi sur WhatsApp et Discord, trop peu pour réentraîner un modèle et bien assez pour en retrouver. Pour chaque message reçu, EmbeddingGemma trouve les cinq réponses que j'ai écrites aux messages les plus semblables, et Gemma 4 les voit comme exemples, avec une courte fiche de style qu'il a rédigée à partir de toutes mes réponses. Chaque réponse que j'envoie s'ajoute, alors les brouillons que j'approuve enseignent le suivant. Les mots de passe, courriels, liens, numéros de téléphone, noms et noms d'entreprise sont caviardés avant d'atteindre une consigne, et les conversations brutes restent dans un dossier hors du dépôt.
La consigne demande; le code s'en assure
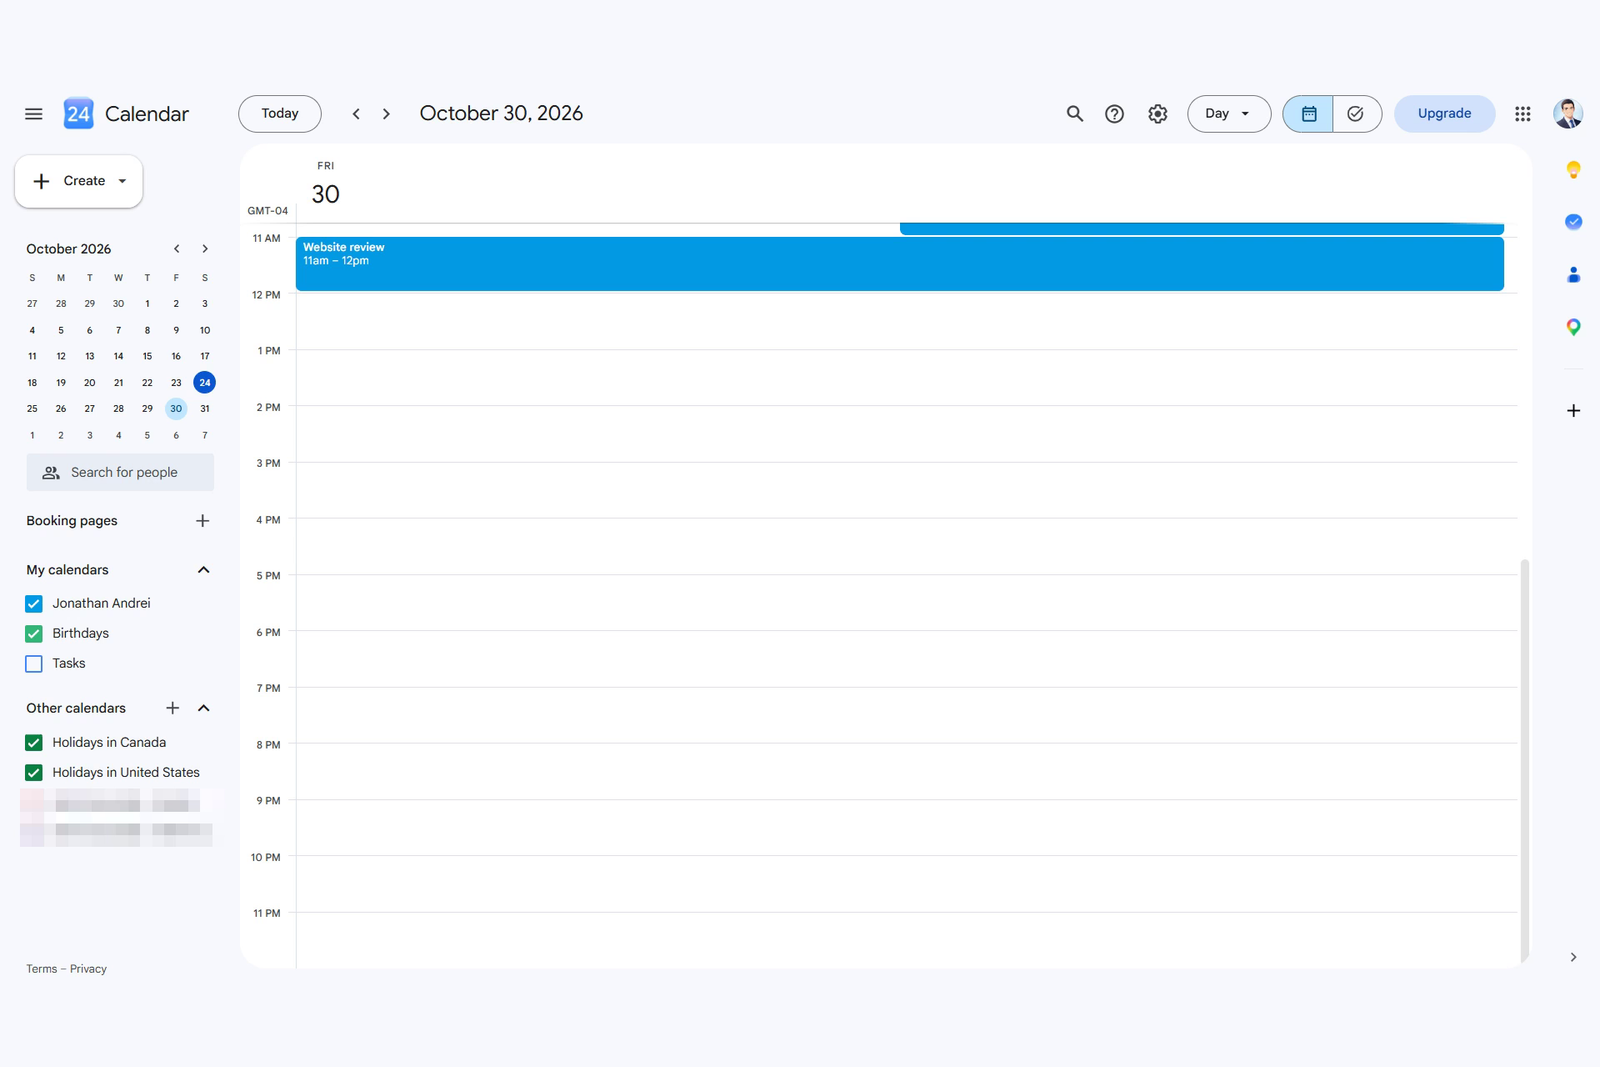
La consigne demande à Gemma de proposer seulement des heures libres, mais une consigne ne garantit rien. Alors draft_reply et move_event refusent toute heure qui chevauche mon agenda, tombe la fin de semaine, sort de 9 h à 18 h ou est déjà passée. Ils refusent aussi une heure écrite dans la réponse qui n'a jamais été passée pour vérification (une première version écrivait « 17h » dans le texte et sautait la vérification), et des mots en français dans une réponse à un message en anglais. Un refus retourne à Gemma comme une erreur et il réessaie. Dans le test des dix demandes, la barrière a attrapé une plage occupée et un glissement vers le français avant qu'ils n'atteignent un brouillon.
Sept sur dix, puis zéro
Gemma 4 seul accepte n'importe quoi. Je lui ai donné dix demandes « on peut déplacer? » dans une semaine chargée, une fois sans mon agenda et une fois comme Spare Thumbs, avec les mêmes exemples de voix les deux fois. Sans l'agenda, 7 des 10 brouillons proposaient une heure où j'étais déjà pris (11 des 14 heures proposées). Spare Thumbs : 0 brouillon sur 10, 0 heure sur 16. À qui demandait de passer de 10 h à 13 h, Gemma seul a écrit « no problem at all, 13h on monday works for me! » alors que 13 h, c'était l'expert en sinistre; Spare Thumbs a écrit « i can't do 13h cuz i have another meeting then, but i'm free at 14h30 or 15h. » L'essai est enregistré dans un fichier de résultats à côté du code et se relance en une commande.
Est-ce que ça sonne comme moi?
Je ne voulais pas que le résultat attende que des amis remplissent un formulaire, alors un modèle d'une autre famille a joué l'ami. Qwen 3.5 (4B) a lu 8 de mes vrais messages, puis a vu un message, ma vraie réponse, la réponse de Gemma avec mes exemples et celle de Gemma sans eux, et a choisi celle que j'ai écrite. Chacun des 15 messages mis de côté a été posé dans les 6 ordres, alors un juge qui préfère « A » ne gagne rien. Il a choisi Spare Thumbs comme étant moi 56 % du temps, ma vraie réponse 33 % et Gemma seul 11 %. Un deuxième juge, Qwen 2.5 (7B), a choisi Gemma seul 53 %, Spare Thumbs 36 % et ma vraie réponse seulement 11 % : il préfère la réponse polie de l'IA à mes propres messages, donc il ne reconnaît pas ma façon d'écrire. Je le rapporte quand même.
Pourquoi il faut des poids ouverts
Les messages de mes clients, ce sont les affaires de mes clients. Je peux faire tourner ça parce que Gemma 4 et EmbeddingGemma sont des poids ouverts qui tournent sur mon propre portable : les courriels, l'agenda et mes 63 vraies réponses ne vont jamais à un modèle hébergé. Les poids ouverts rendent aussi la barrière possible. Je peux entourer le modèle de code qui refuse, réessaie et consigne chaque étape, et toute la boucle tient dans un fichier d'une centaine de lignes.
Ce qui n'est pas revendiqué
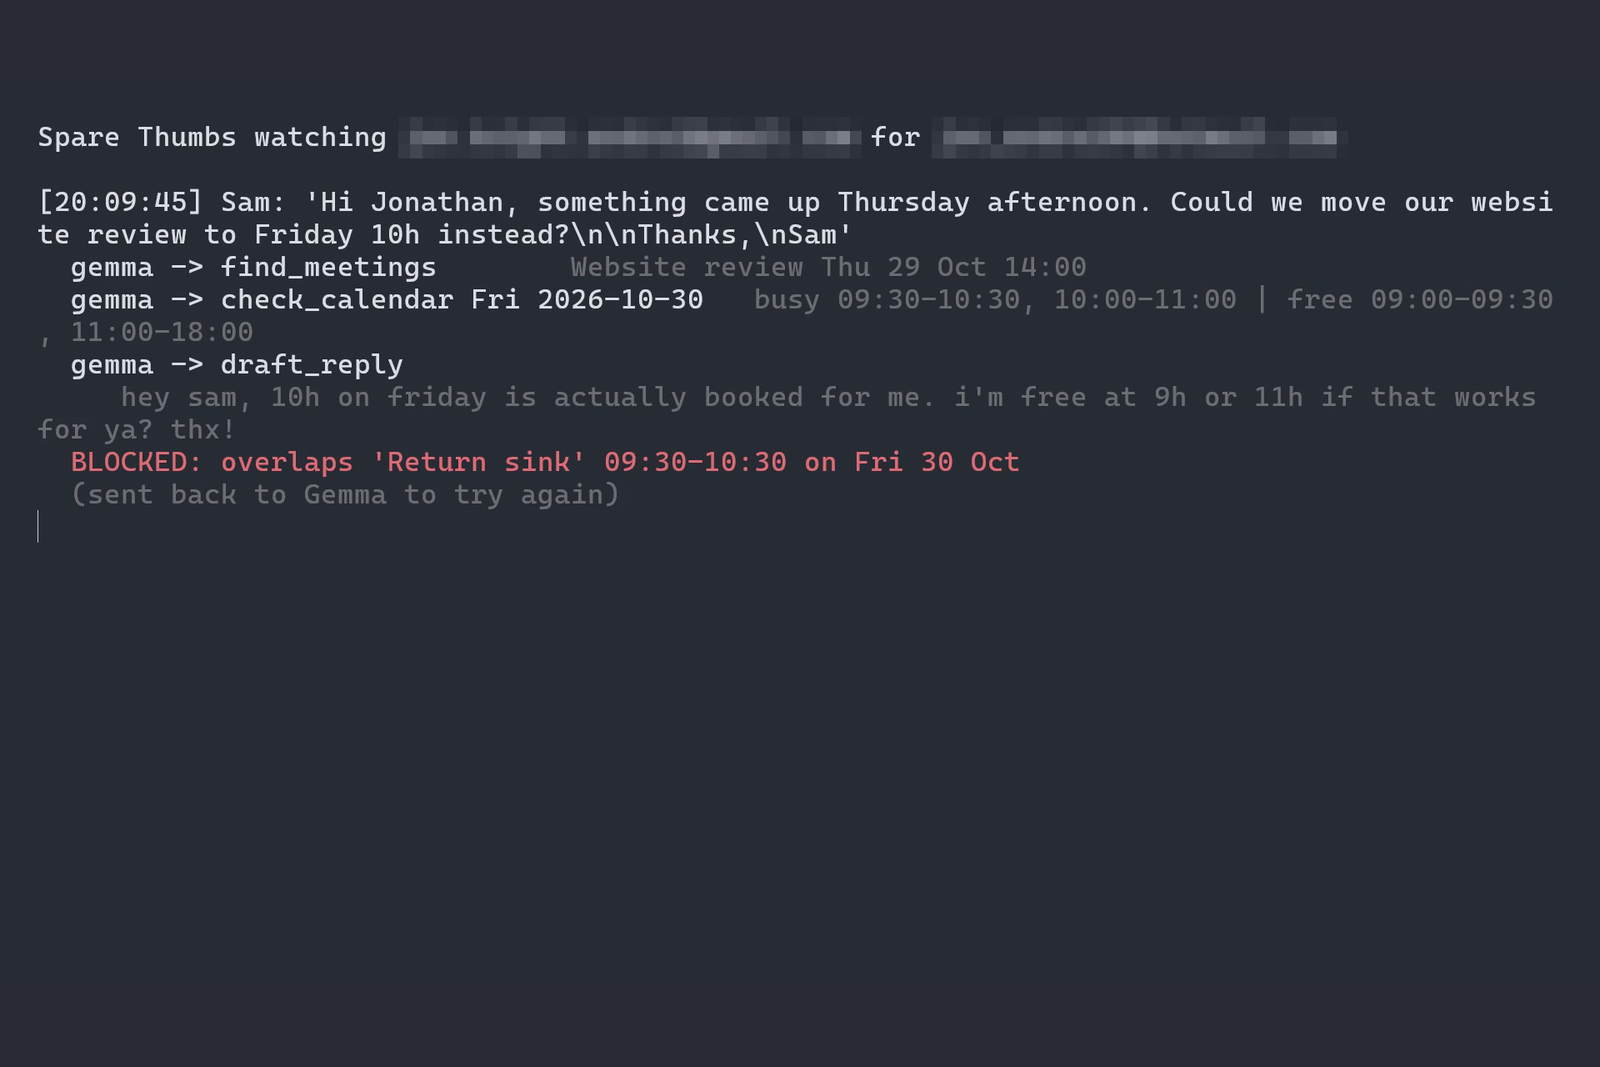
Le 7 sur 10 contre 0 sur 10 est corrigé par l'agenda, pas par moi, mais la semaine chargée derrière est inventée pour que le test se répète, et dix demandes, c'est un petit échantillon. La démo est le premier essai en direct sur mon vrai agenda, avec une deuxième adresse à moi qui joue le client : ses deux messages ont été placés dans ma boîte avec l'API Gmail parce que je ne pouvais pas envoyer depuis ce compte pendant le tournage. Le résultat sur la voix est le jugement d'un modèle, pas celui de gens qui me connaissent, et les deux juges ne s'entendent pas. Il ne fait que des brouillons : rien ne se rend à un client avant que j'appuie sur Envoyer. Il répond seulement dans Gmail et Google Agenda, et seulement aux expéditeurs d'une liste autorisée; mes messages WhatsApp et Discord lui ont appris ma voix, mais il n'y répond pas encore.
Spare Thumbs: Gemma 4 on my laptop answers "can we move the meeting?" in my words, from my real Google Calendar, and never offers a time I am already booked
Voir le projet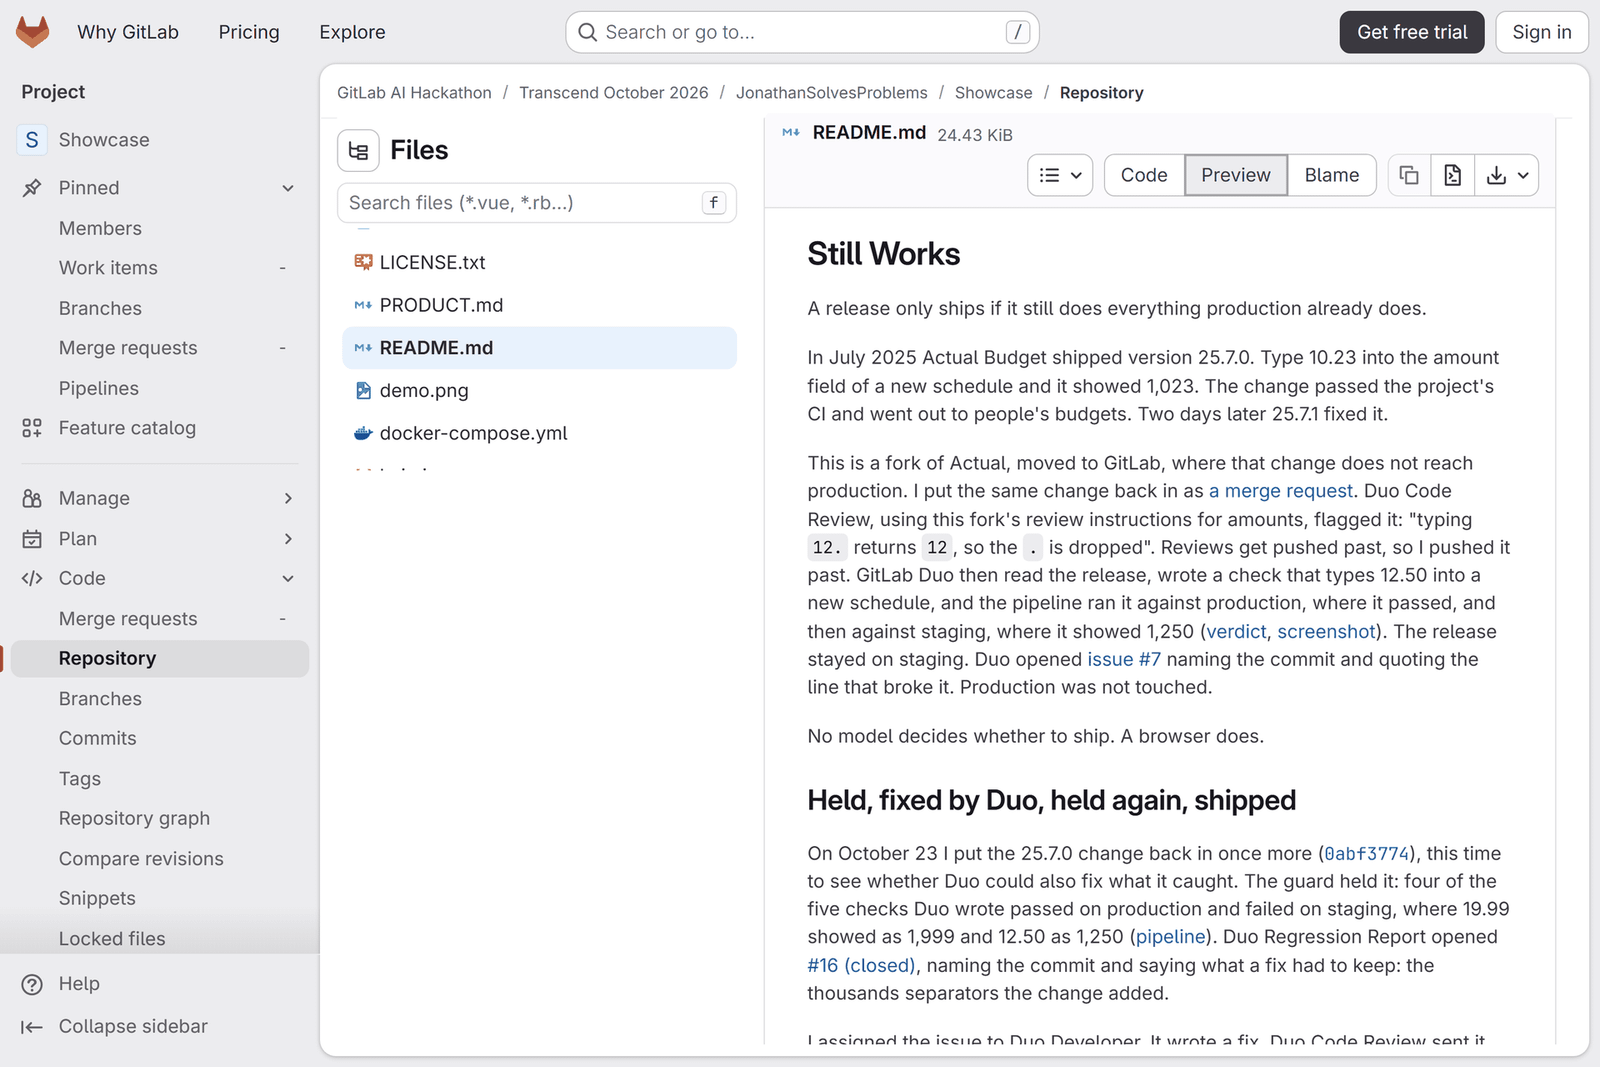
L'intégration continue d'Actual Budget a laissé passer un bogue qui enregistrait 10.23 comme 1,023. J'ai confié la publication à GitLab Duo.
Still Works déplace Actual Budget sur GitLab avec un pipeline qui ne publie une version que si elle fait encore tout ce que la production fait déjà. GitLab Duo écrit des vérifications de navigateur, garde celles qui passent en production, et une version retenue passe à Duo Developer et à Duo Code Review jusqu'à ce que la barrière la laisse sortir. Rejoué sur onze régressions étiquetées par les responsables : 2 à 3 arrêtées, contre 1 pour un test de fumée.
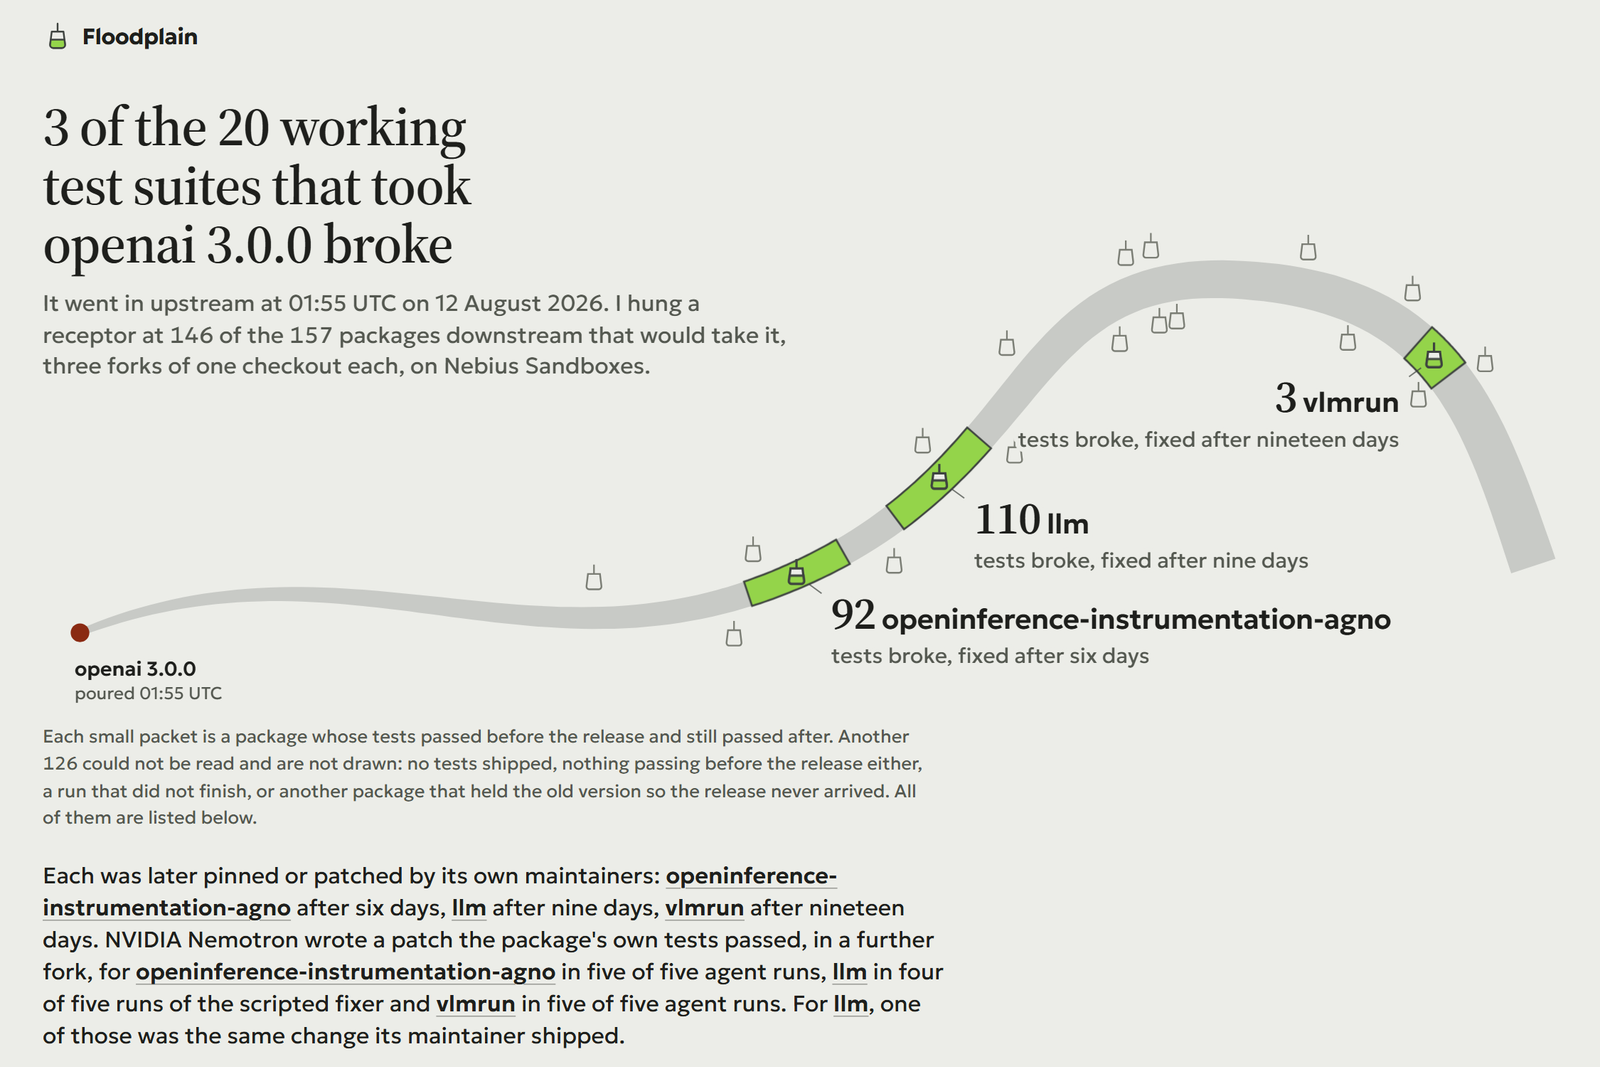
Lancé avant la sortie d'openai 3.0.0, il a trouvé les 3 paquets que la version brisait. Nemotron a écrit le même verrouillage que le responsable a publié neuf jours plus tard.
openai 3.0.0 a brisé les nouvelles installations de llm, de Simon Willison, et la correction a pris neuf jours. Floodplain exécute les suites de tests des projets dépendants dans des Nebius Sandboxes avant la sortie. Avec le wheel non publié d'OpenAI lui-même, il a trouvé les 3 mêmes cassures que la vraie sortie, avec les mêmes tests brisés, et NVIDIA Nemotron a écrit des correctifs que leurs suites acceptent.
À lire aussi
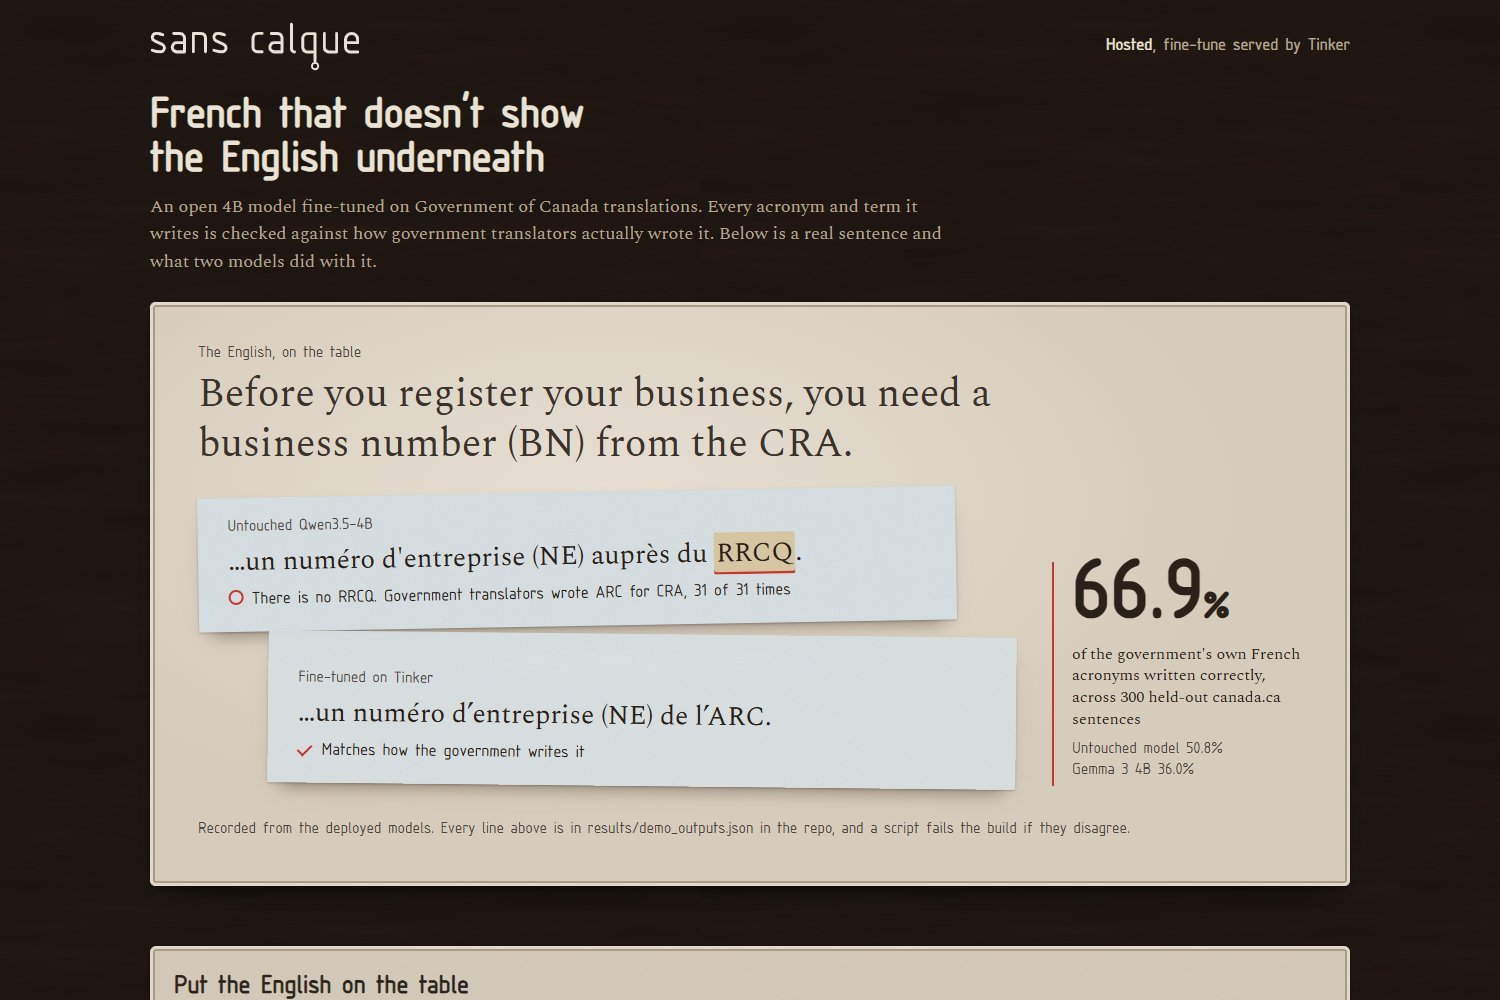
Un affinage à 1,35 $ a appris à un modèle ouvert de 4B que la CRA, c'est l'ARC en français. Il écrit encore NIS pour SIN.
Un modèle ouvert de 4B a traduit « a business number from the CRA » et a écrit RRCQ, un organisme qui n'existe pas. Je l'ai affiné sur Tinker pour environ 1,35 $ sur des traductions du gouvernement du Canada. Sur des pages canada.ca mises de côté, il écrit maintenant le sigle français du gouvernement 66,9 % du temps, contre 50,8 %. Chaque signalement cite sa source, et il tourne sur mon portable.

Une carte de bingo de ce qui est dehors près de chez vous en octobre, classée par un modèle ouvert sur un portable
Autour de Hawkesbury, en Ontario, iNaturalist compte environ 3 000 observations de qualité recherche au total, et l'espèce la plus consignée sur tous les mois d'octobre connus a quatre observations. Trop peu pour classer une petite ville seule. Nature Bingo emprunte à 48 villes voisines : TabPFN, un modèle à poids ouverts sur mon portable, apprend dix ans de mois d'octobre et classe les 16 choses les plus susceptibles d'être dehors ce mois d'octobre. Dans un test à l'aveugle sur octobre 2025, sa carte a battu la liste d'octobre dernier de chaque ville dans 23 villes, égalé dans 14 et perdu dans 11. Puis j'ai sorti la carte de Hawkesbury sur mon téléphone et je l'ai parcourue.