Un affinage à 1,35 $ a appris à un modèle ouvert de 4B que la CRA, c'est l'ARC en français. Il écrit encore NIS pour SIN.
Un modèle ouvert de 4B a traduit « a business number from the CRA » et a écrit RRCQ, un organisme qui n'existe pas. Je l'ai affiné sur Tinker pour environ 1,35 $ sur des traductions du gouvernement du Canada. Sur des pages canada.ca mises de côté, il écrit maintenant le sigle français du gouvernement 66,9 % du temps, contre 50,8 %. Chaque signalement cite sa source, et il tourne sur mon portable.
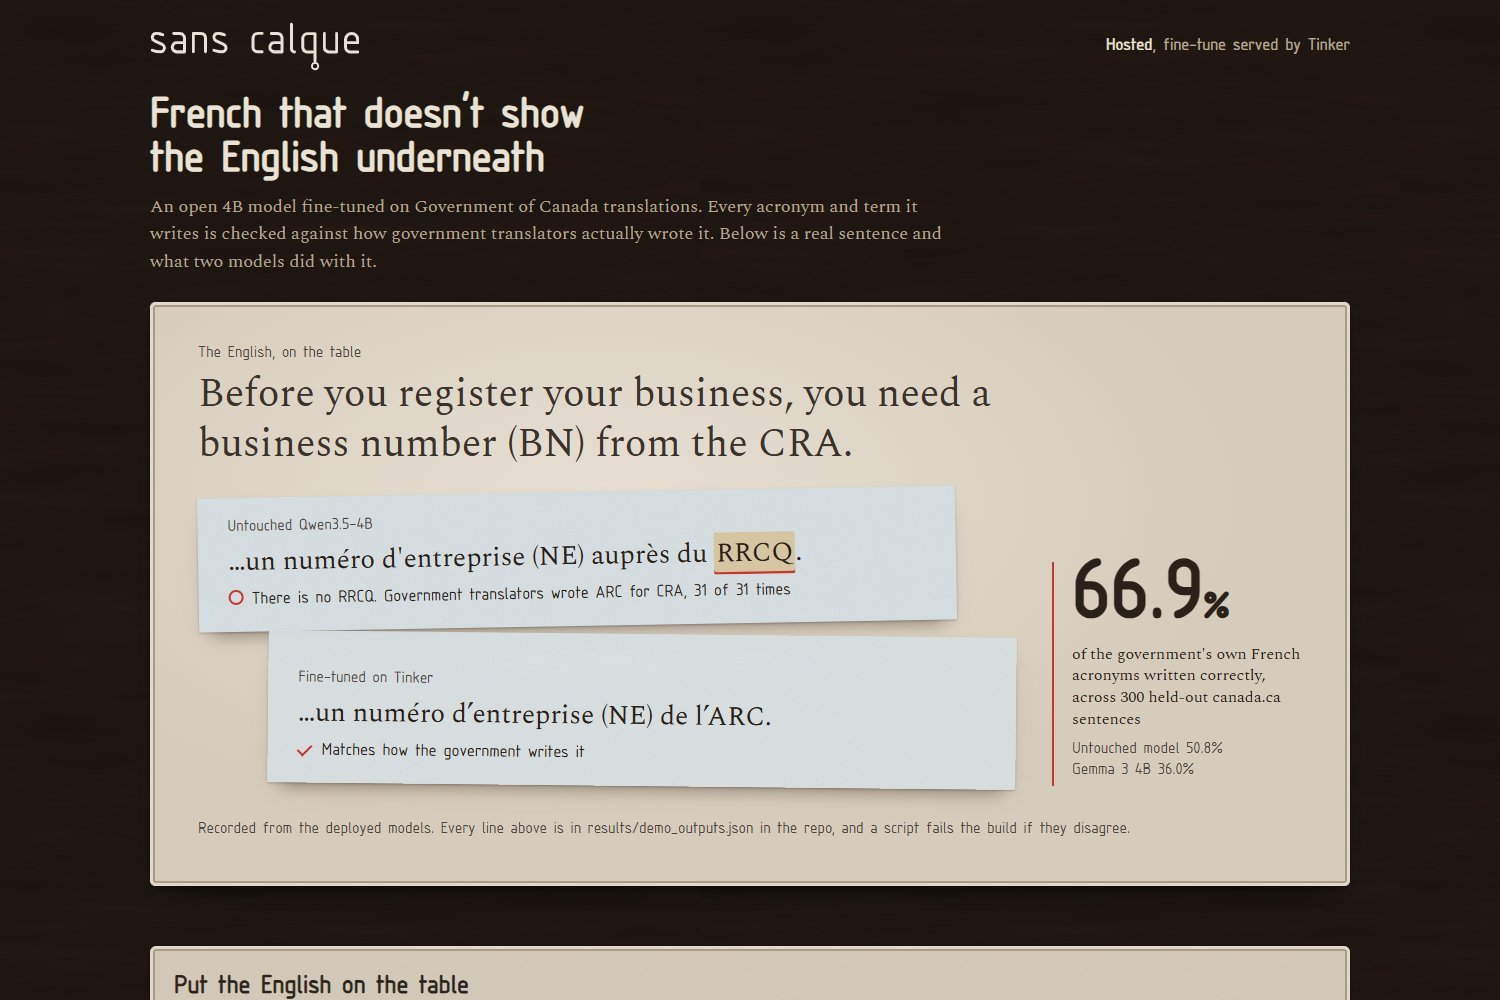
Le RRCQ n'existe pas
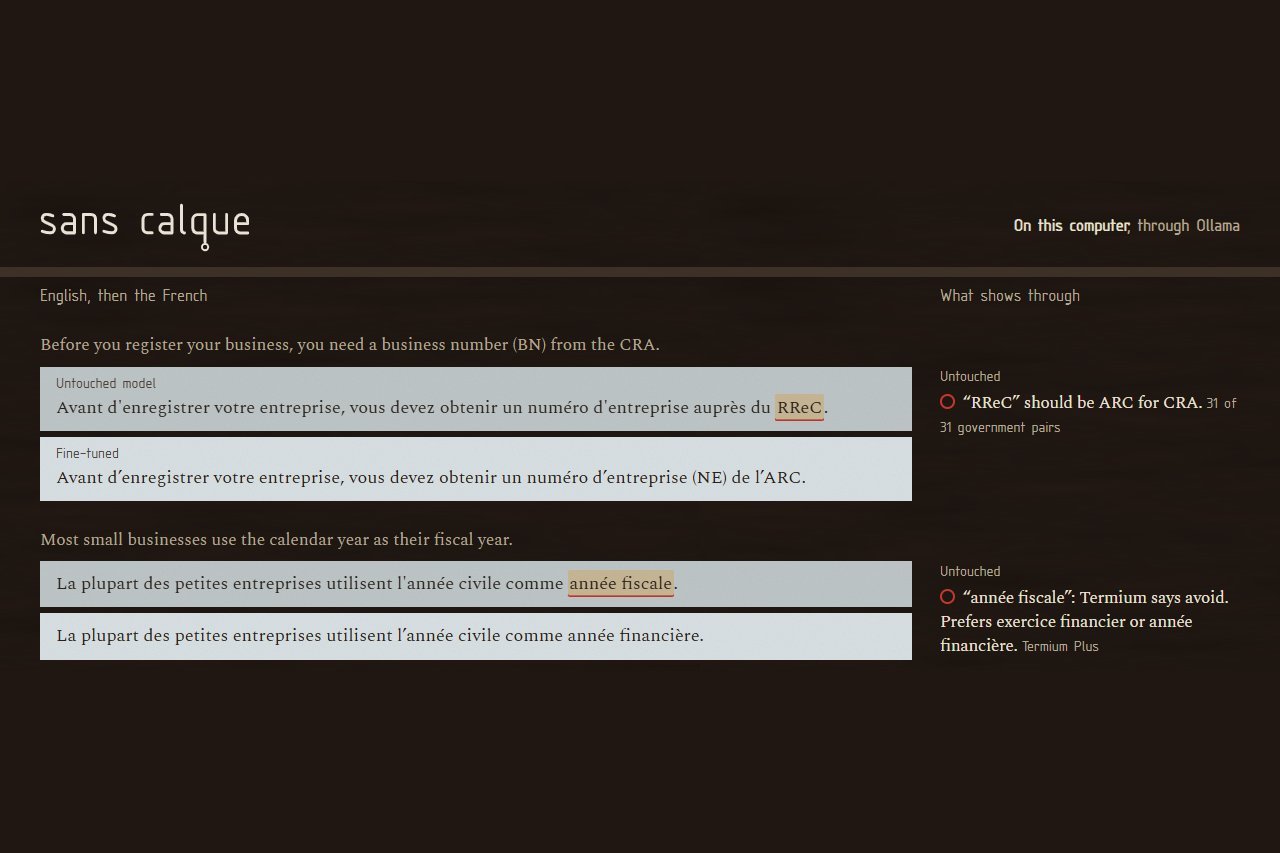
Chaque page de mon site a une jumelle en français. Je bâtis des choses à côté (envoyez-moi un brief, recevez une démo fonctionnelle en 48 heures), et le site est en anglais et en fr-CA, alors chaque nouvelle page veut dire une traduction. J'ai donc donné à un modèle ouvert de 4B une phrase qu'on trouve sur n'importe quelle page d'entreprise canadienne : « you need a business number (BN) from the CRA ». Il a écrit « auprès du RRCQ ». Le RRCQ n'existe pas. L'Agence du revenu du Canada, c'est l'ARC en français, et dans les données ouvertes du Canada, les traducteurs du gouvernement ont écrit ARC les 31 fois où la paire apparaît.
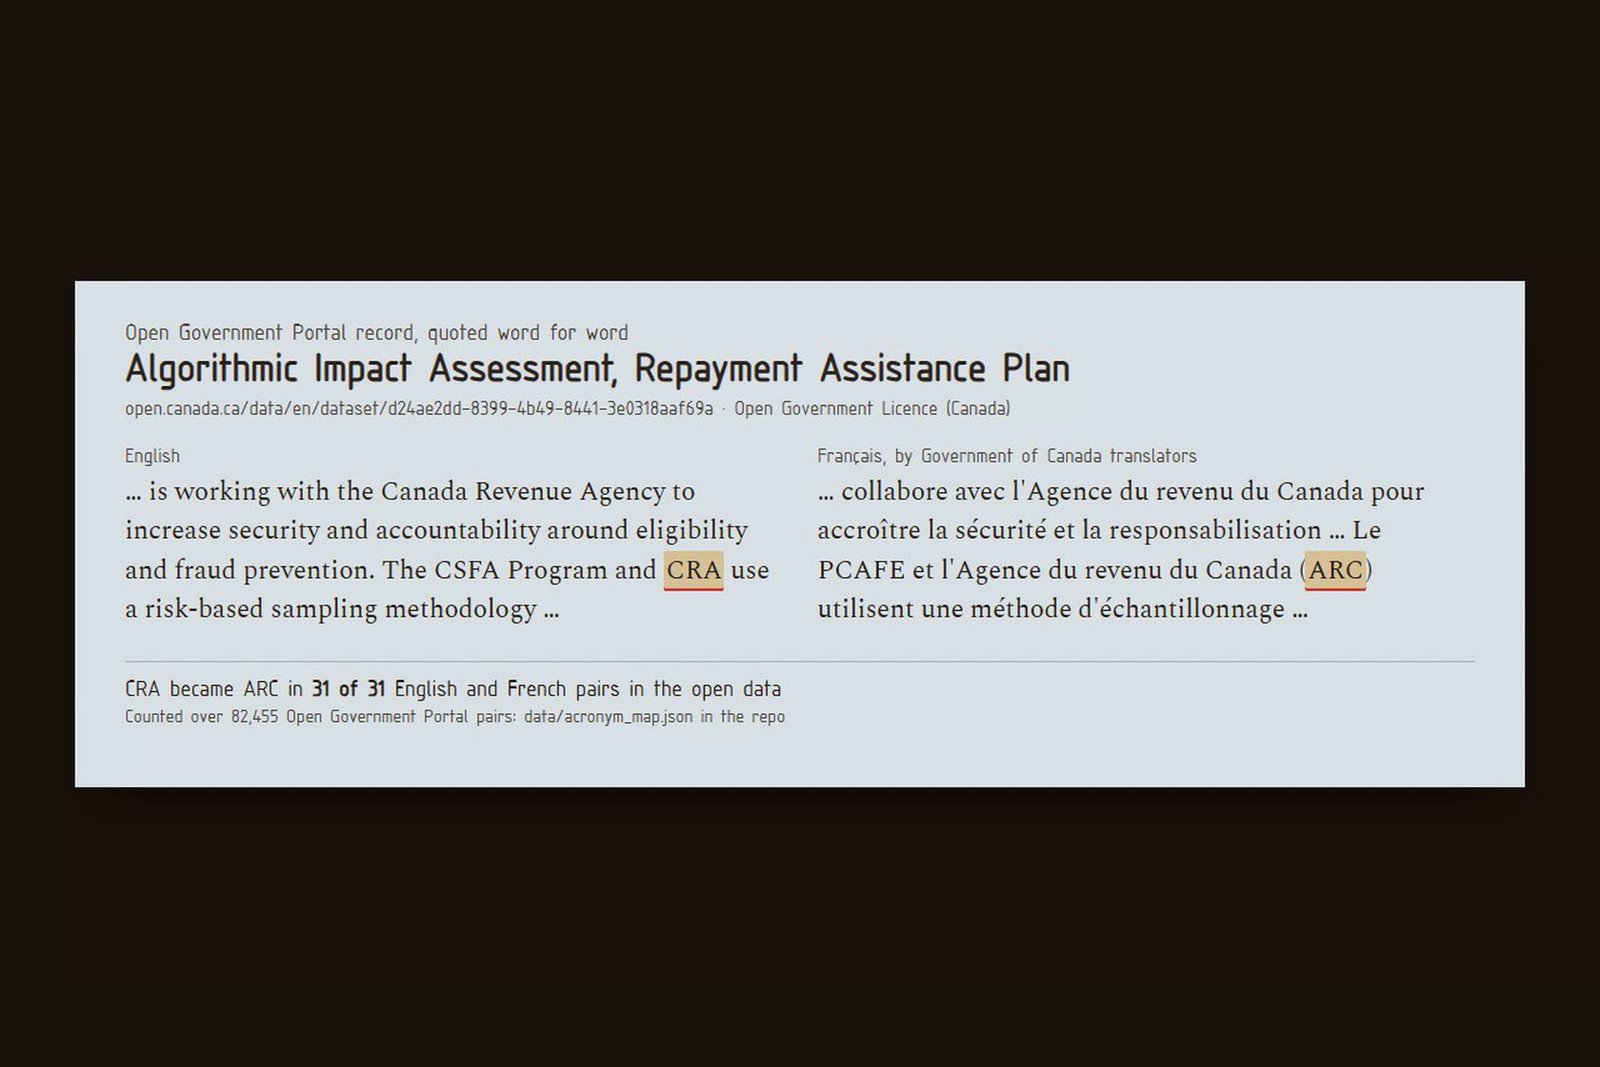
À qui ça sert
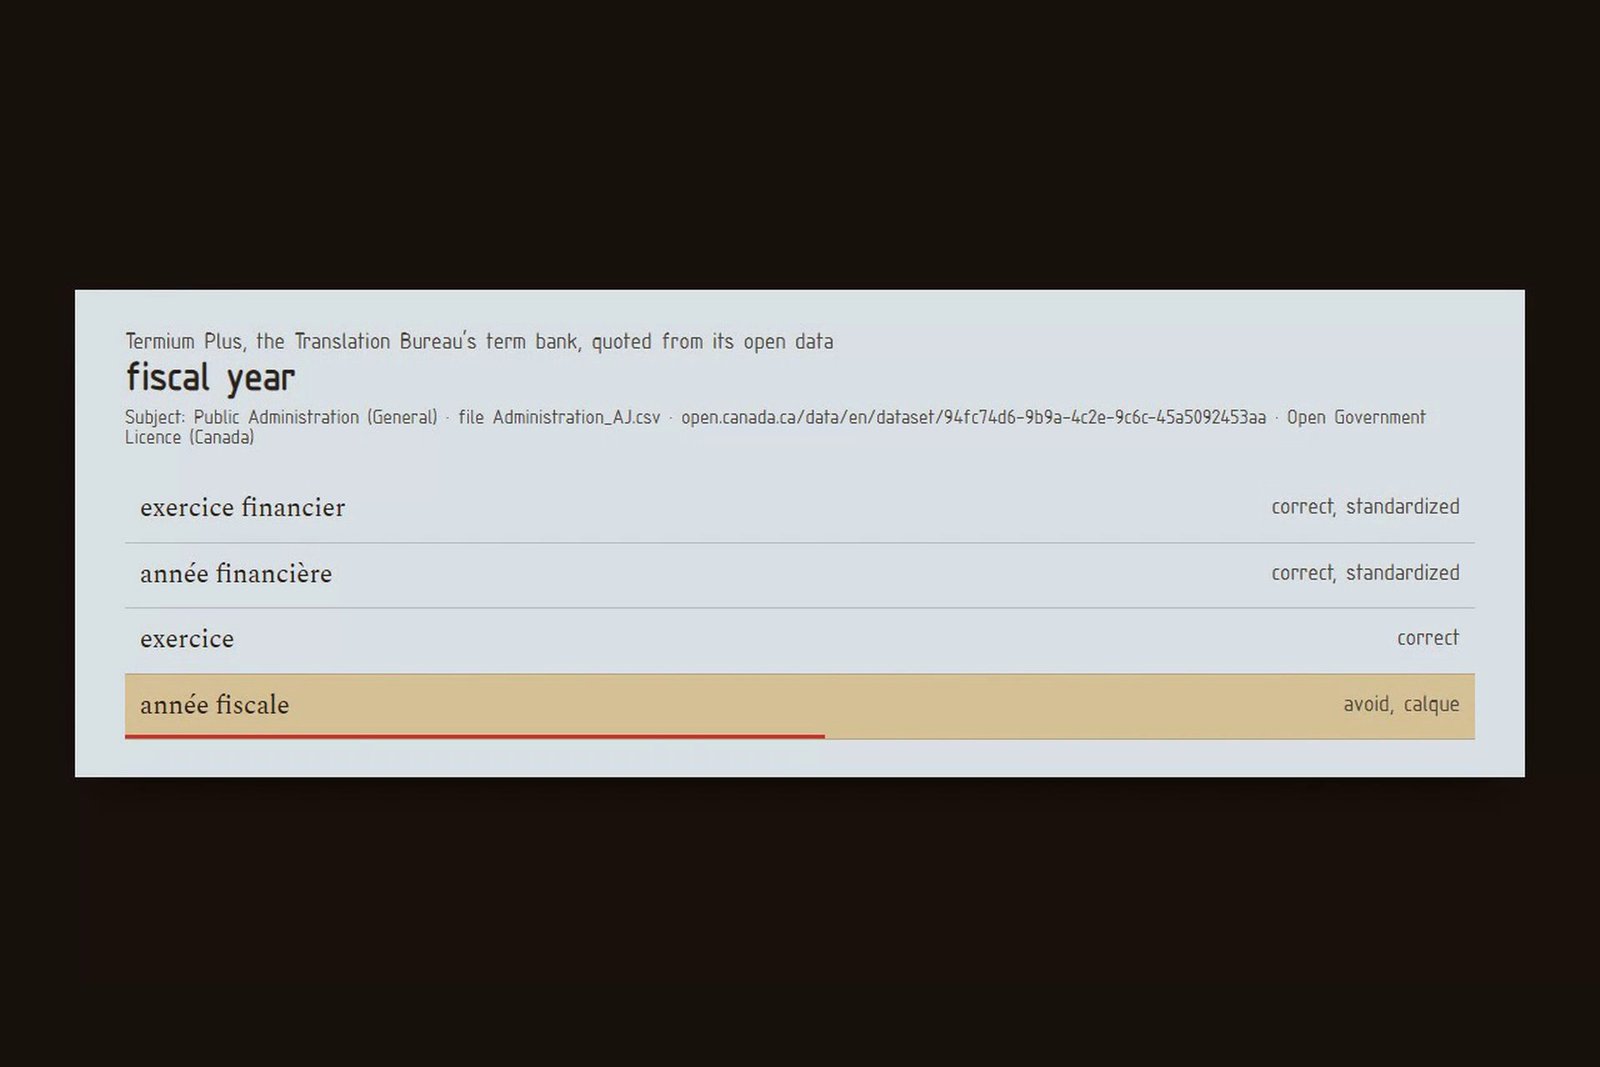
Une petite entreprise paie un pigiste bilingue à la page pour mettre son site en français. Le client ne lira pas le français de près, mais il remarquera CRA là où on devrait lire ARC. Avec un modèle ouvert sur le portable du pigiste, il n'y a pas de facture au mot, et le texte du client ne quitte jamais la machine. Sans calque donne à ce pigiste le français du modèle affiné à côté du modèle de base intact, avec une liste de révision qui signale trois choses : un sigle anglais resté dans le français, un sigle français manquant que le gouvernement utilise (ARC pour CRA, NAS pour SIN, à partir de 466 paires apprises des données ouvertes), et un terme que Termium Plus, du Bureau de la traduction, dit d'éviter.
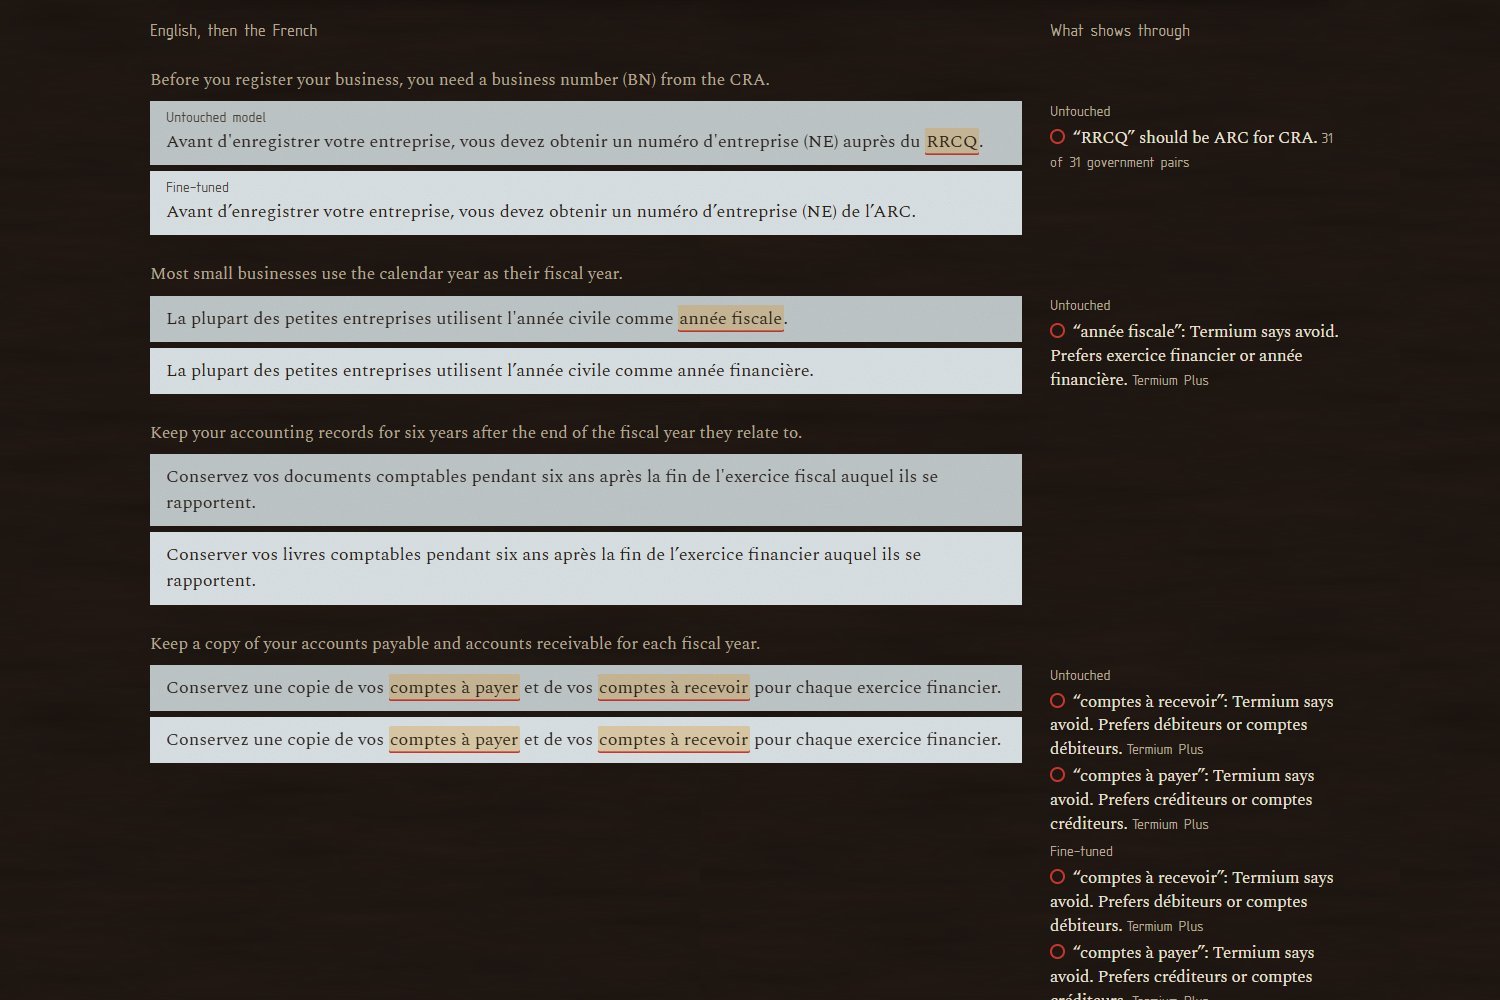
Rien n'est corrigé en silence. Sur « most small businesses use the calendar year as their fiscal year », le modèle intact écrit année fiscale et le modèle affiné écrit année financière. Les deux modèles écrivent « comptes à payer » pour accounts payable, que Termium signale aussi, et la vérification le repère chez les deux. Une phrase signalée va sur la liste de révision, et la boîte « French, ready to send » dit combien de blocs vérifier avant que ça parte chez le client.
Entraîné sur les textes ouverts du gouvernement
Les données sont toutes ouvertes. Chaque jeu de données du Portail du gouvernement ouvert a son titre et sa description dans les deux langues, sous la Licence du gouvernement ouvert. J'ai récupéré les 48 116 fiches, retiré celles dont le portail marque le français comme traduit par machine, et apparié les paragraphes et les phrases seulement quand les deux côtés se découpent de la même façon. Ça a donné 82 455 paires. L'affinage, ce sont deux passes sur Tinker : Qwen3.5-4B, LoRA de rang 32, 8 000 paires, 2 époques, environ 13 minutes chacune. La passe 1 était un échantillon aléatoire. La passe 2 a tiré 2 000 de ses paires des 10 752 qui contiennent un sigle connu, parce que la passe 1 écrivait encore « de la RC » pour CRA. Coût estimé, d'après le prix par jeton de Tinker et le nombre réel de jetons : 1,26 $ et 1,35 $. Le script d'entraînement refuse de démarrer si l'estimation dépasse le budget, parce que le crédit était un montant unique de 10 $.
Corrigé par les traducteurs du gouvernement
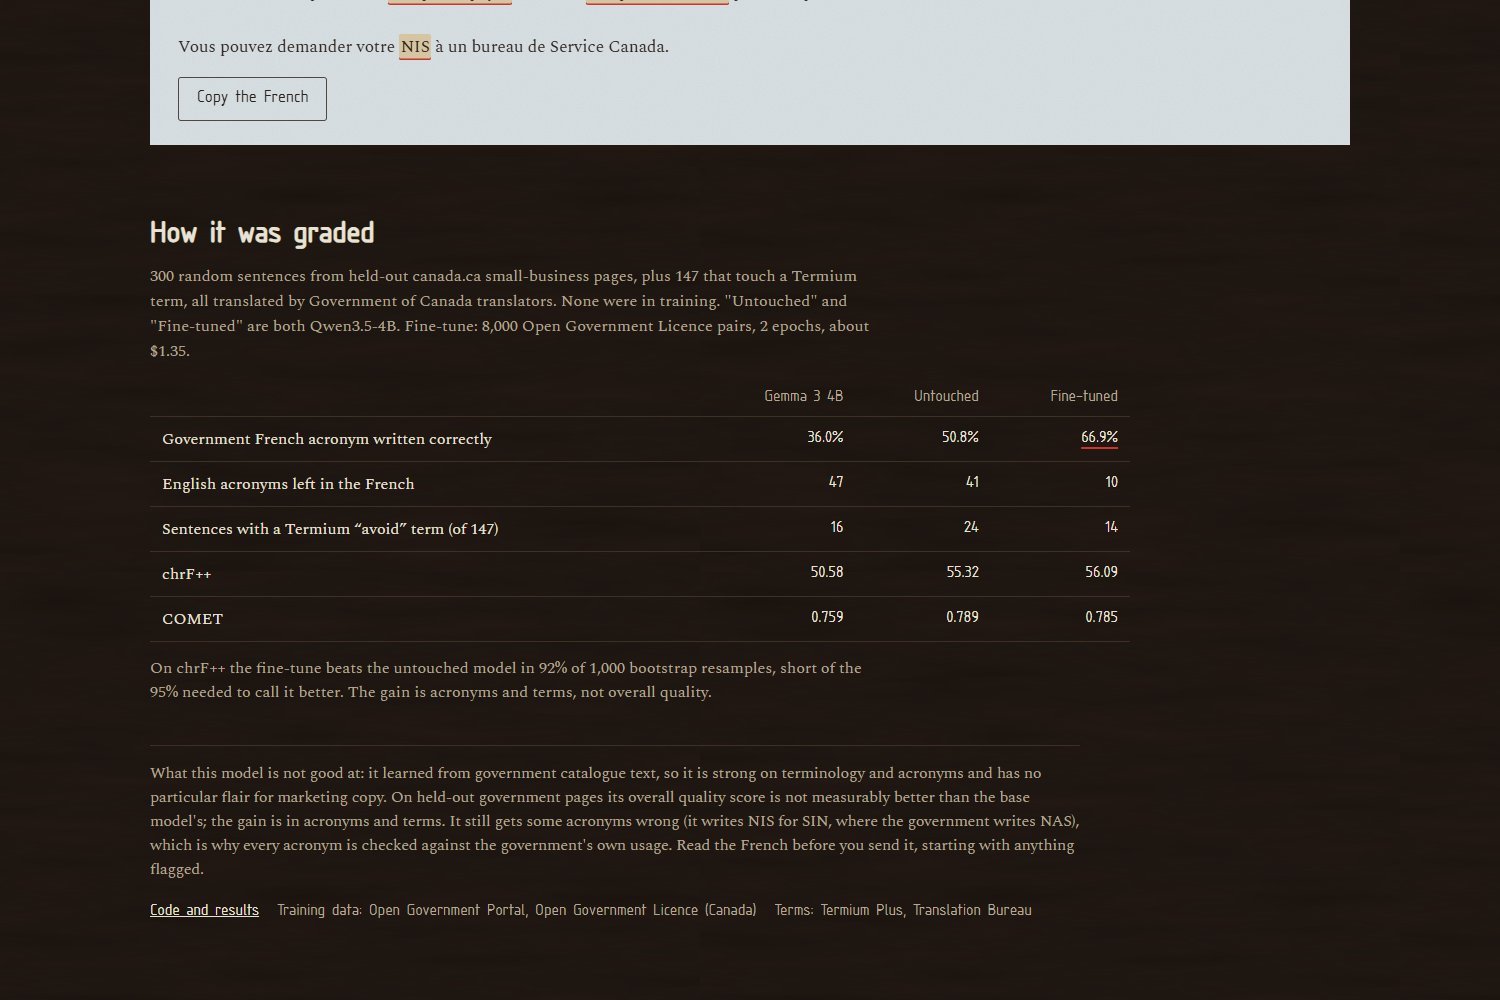
J'ai tout noté sur des pages canada.ca pour petites entreprises, dont le français a été écrit par des traducteurs du gouvernement du Canada : 300 phrases au hasard, plus les 147 qui touchent un concept « à éviter » de Termium. Aucune de ces phrases n'était dans l'entraînement. Le sigle français du gouvernement est sorti correctement 36,0 % du temps avec Gemma 3 4B, 50,8 % avec le Qwen3.5-4B intact, 55,8 % avec la passe 1 et 66,9 % avec la passe 2. Les sigles anglais restés dans le français sont passés de 41 à 10. Le gain sur les sigles tient : la passe 2 bat le modèle de base dans les 1 000 rééchantillonnages bootstrap des 146 phrases mises de côté qui contiennent un sigle français du gouvernement. La qualité globale, non : sur le chrF++ (55,32 contre 56,09), la passe 2 est devant dans 92 % des rééchantillonnages, et j'avais fixé le seuil à 95 % avant de lancer le calcul.
Il fait encore des erreurs
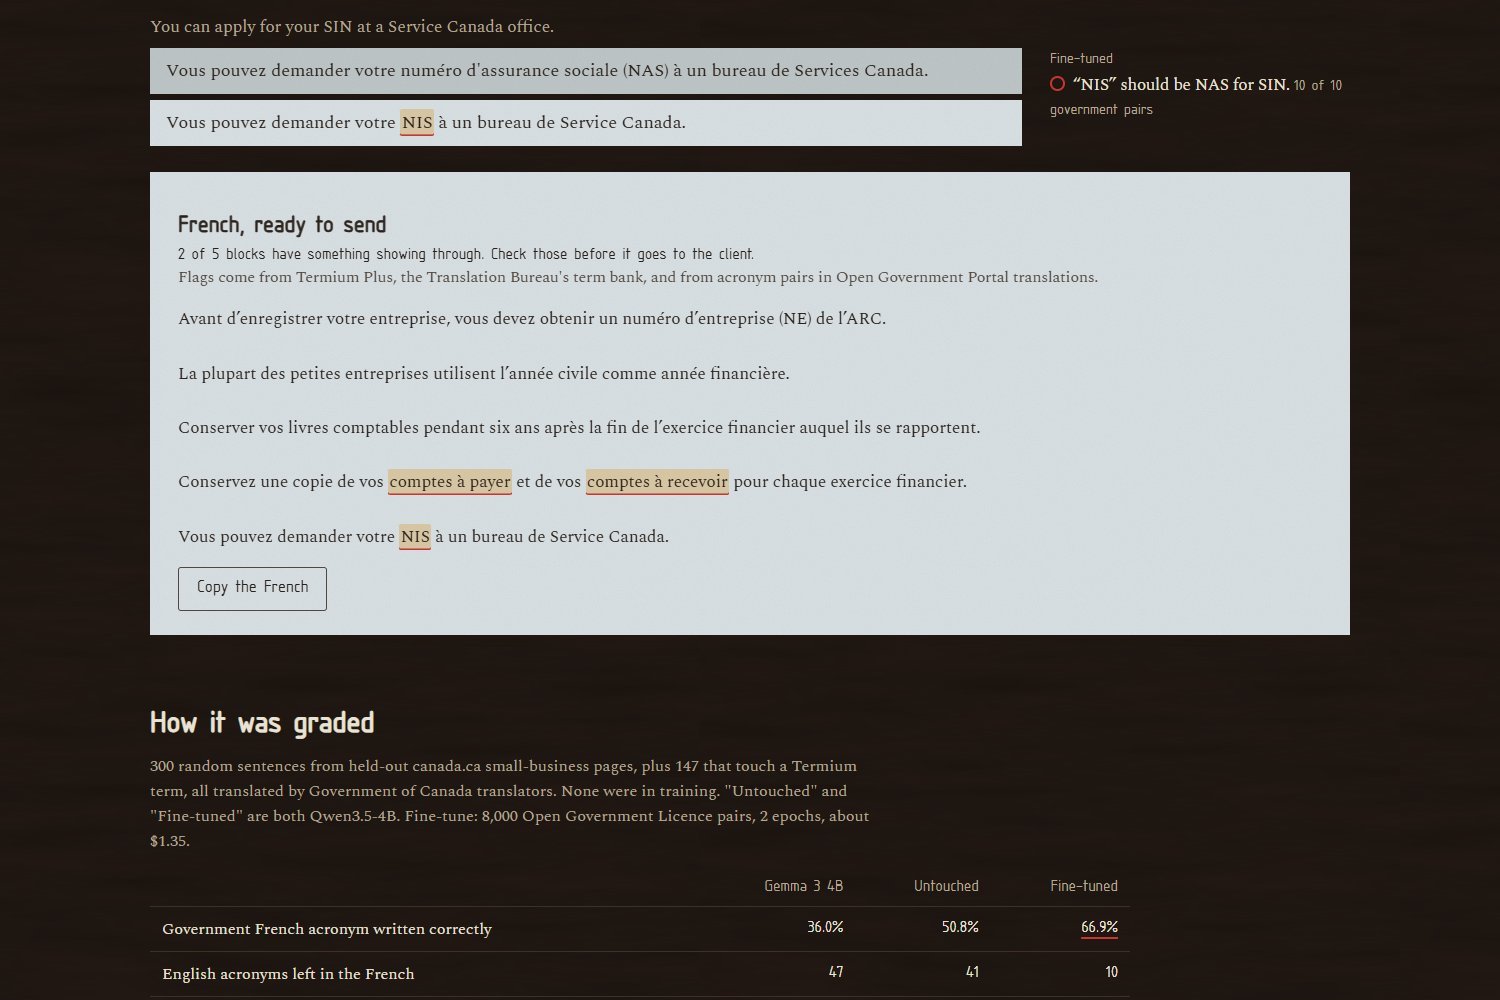
Il n'a pas toujours raison, et le modèle de base a parfois raison. Sur « you can apply for your SIN », le modèle de base écrit « numéro d'assurance sociale (NAS) », ce qui est correct. La passe 2 écrit « NIS ». La vérification des sigles le repère, parce que le gouvernement a écrit NAS dans 10 paires sur 10. La passe 2 a aussi écrit « Conserver » là où une consigne demande « Conservez », et aucune de mes vérifications ne repère celle-là. La passe 2 n'est pas meilleure partout non plus : elle laisse plus de sigles anglais et plus de termes Termium que la passe 1. Je la sers quand même parce qu'elle réussit les sigles qu'un client remarque, et la boîte dit encore de relire le français avant de l'envoyer.
Les vérifications ont été vérifiées aussi
Ma première vérification Termium signalait les propres traducteurs du gouvernement 21 fois sur 25. L'étiquette qu'elle comptait, « à éviter, voir observation », veut dire à éviter dans certains contextes seulement, alors je l'ai retirée. Ce qui reste signale la traduction humaine une seule fois, pour « année fiscale », que Termium appelle un calque et que canada.ca utilise encore. Je l'ai laissée. Un script, check_claims.py, reconstruit chaque chiffre du README à partir des fichiers de résultats et échoue si le texte et les données ne concordent pas. Il échoue aussi si une sortie de modèle citée dans la documentation n'est pas dans les sorties enregistrées.
Les poids m'appartiennent
J'ai exporté le modèle affiné de Tinker, je l'ai converti en un fichier 4 bits de 2,59 Go, et il tourne dans Ollama sur le GPU de 8 Go de mon portable à 32,5 jetons par seconde. La même page web tourne avec lui : je l'ai chargée en bloquant toute requête vers l'extérieur de mon portable, et elle a quand même traduit, polices comprises, sans aucune requête sortante. Ça m'a coûté trois culs-de-sac : Ollama n'accepte plus les adaptateurs LoRA, son propre quantificateur demande un Mac, et un fichier 8 bits tournait à 0,8 jeton par seconde. Passer à 4 bits peut coûter quelque chose, alors j'ai noté les copies locales sur le même test. Pour la passe 1, ça a coûté (chrF++ 54,96 contre 55,65 dans le nuage). Pour la passe 2, non : 56,43 contre 56,09, et 67,8 % des sigles du gouvernement contre 66,9 %. Statistiquement, c'est le même modèle, alors je le lis comme rien de perdu, pas comme un portable meilleur.
Mon premier utilisateur, c'était mon propre site
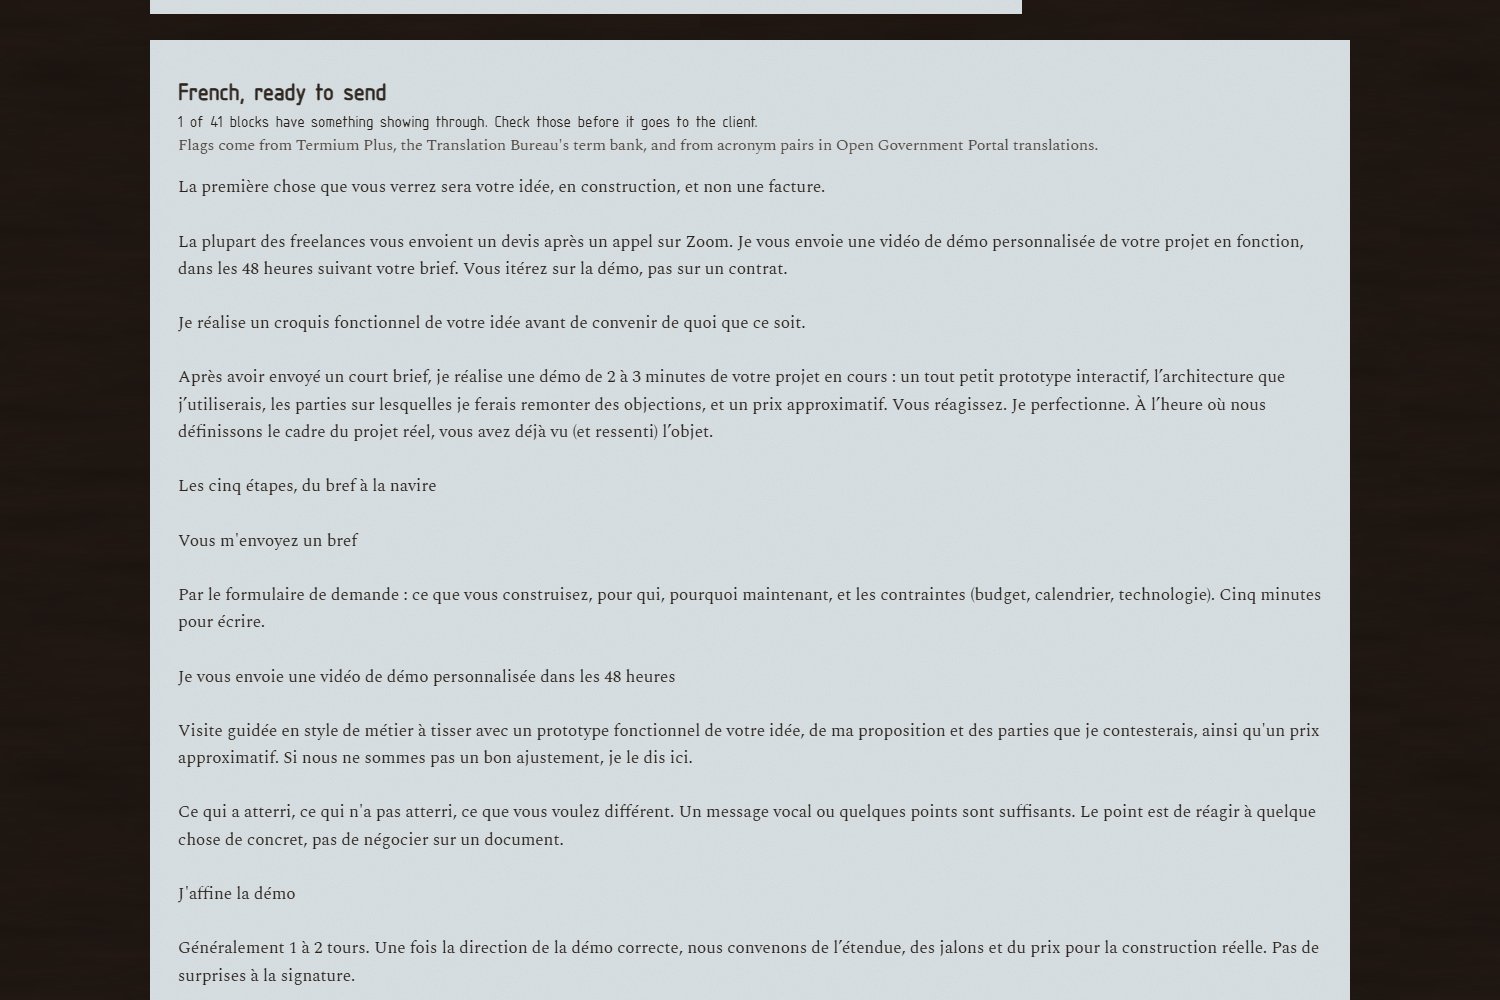
J'ai collé la page anglaise « How I work » de ce site dans l'application en ligne : 41 blocs. Le modèle affiné a levé 8 signalements. 7 étaient du bruit pour ce genre de texte : MCP, LLM, RAG, FHIR, SDK et un code de ligne directrice du NICE, tous des sigles que ma propre page française garde en anglais. La règle des sigles a appris comment le gouvernement écrit, et le jargon technique ne la suit pas. Le 8e était réel. Ma phrase dit que les journaux contenaient des données « the AI had already claimed was PHI-free », et le français est revenu en « lesquels avaient déjà été déclarés exempts », ce qui veut dire « qui avaient déjà été déclarés exempts ». L'IA a disparu de la phrase, alors qu'elle en était tout le sens. J'ai donc bâti ce que ça m'indiquait : une liste « garder en anglais » par client, et une boîte « Fetch the page » pour qu'une page arrive par son adresse. Même page, récupérée par l'application, avec ces termes sur la liste : 8 signalements sont devenus 1, et celui qui reste est la vraie prise.
Ce qui n'est pas revendiqué
Le chiffre principal est corrigé par un texte que je n'ai pas écrit : des traducteurs du gouvernement du Canada sur des pages canada.ca mises de côté, et c'est la seule raison pour laquelle il vaut quelque chose. Il reste étroit. Le gain porte sur les sigles et les termes; la qualité globale de la traduction n'est pas mesurablement meilleure, et j'ai fixé le seuil pour le dire avant de regarder. Les vérifications ne savent que ce que savent les données ouvertes du gouvernement et Termium, alors elles ratent des erreurs comme « Conserver » pour « Conservez », et elles signalent trop de sigles techniques tant que la liste « garder en anglais » du client n'est pas réglée. Le modèle a appris sur du texte de catalogue gouvernemental, alors il n'a pas de talent particulier pour le texte publicitaire. Et la recette (affiner sur les textes bilingues ouverts d'un gouvernement, puis vérifier chaque terme dans sa banque terminologique) devrait s'appliquer ailleurs, comme avec l'IATE de l'Union européenne, mais je ne l'ai mesurée qu'ici.
Sans calque: English to Canadian French from an open 4B model I fine-tuned for $1.35 on government translations, with every flag citing where its rule came from
Voir le projetÀ lire aussi

Une carte de bingo de ce qui est dehors près de chez vous en octobre, classée par un modèle ouvert sur un portable
Autour de Hawkesbury, en Ontario, iNaturalist compte environ 3 000 observations de qualité recherche au total, et l'espèce la plus consignée sur tous les mois d'octobre connus a quatre observations. Trop peu pour classer une petite ville seule. Nature Bingo emprunte à 48 villes voisines : TabPFN, un modèle à poids ouverts sur mon portable, apprend dix ans de mois d'octobre et classe les 16 choses les plus susceptibles d'être dehors ce mois d'octobre. Dans un test à l'aveugle sur octobre 2025, sa carte a battu la liste d'octobre dernier de chaque ville dans 23 villes, égalé dans 14 et perdu dans 11. Puis j'ai sorti la carte de Hawkesbury sur mon téléphone et je l'ai parcourue.
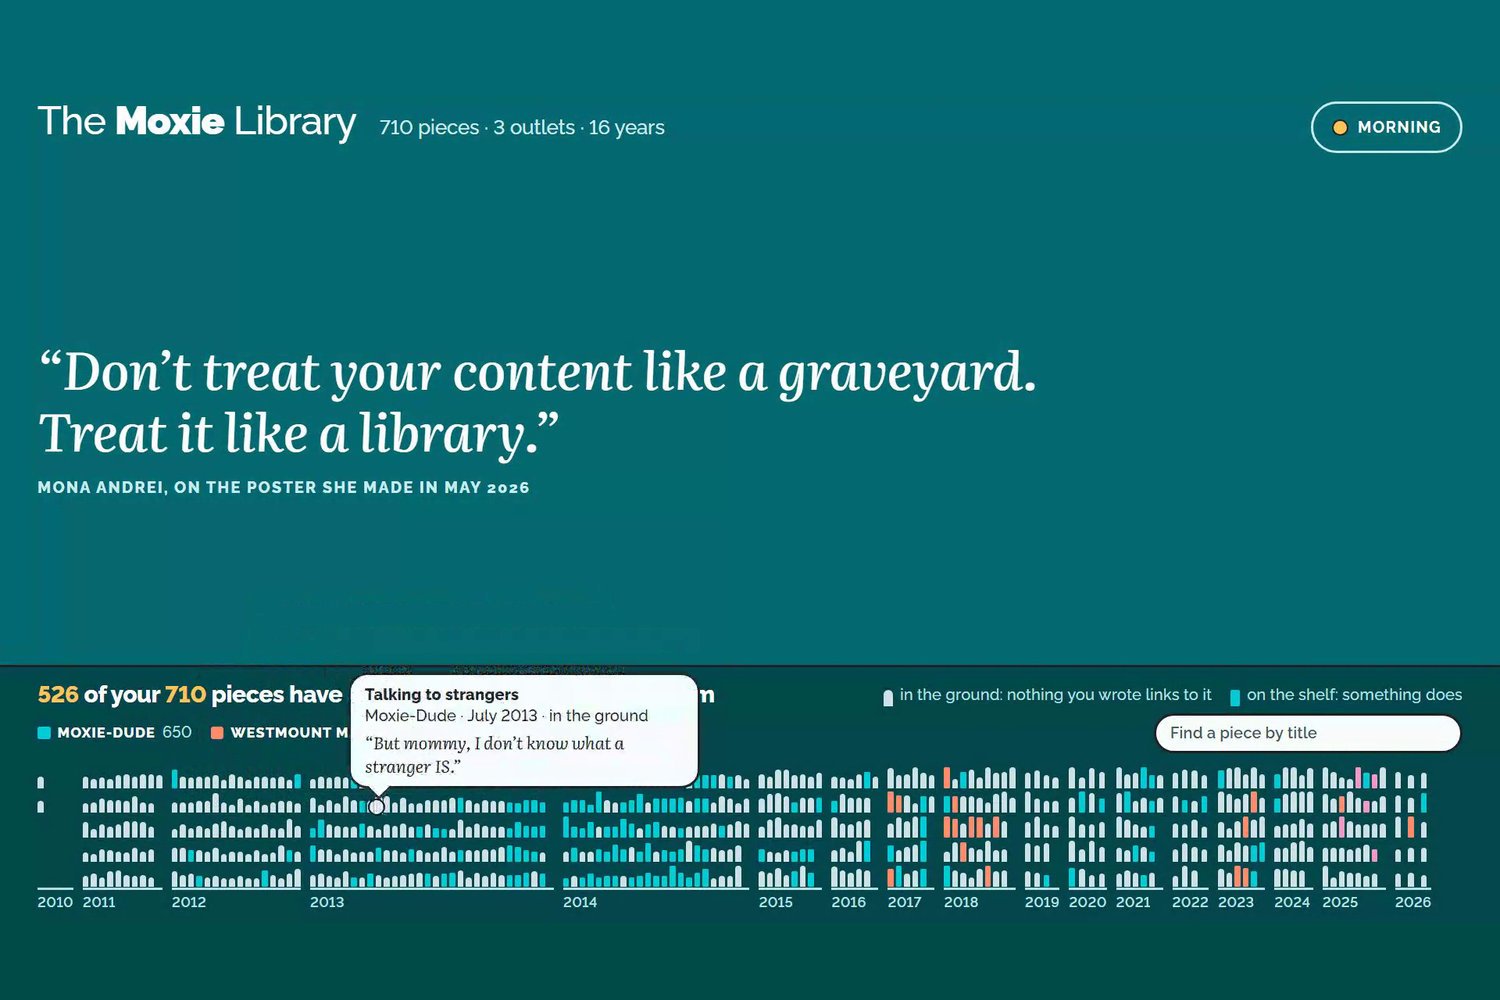
Ma mère a publié 710 textes en 16 ans. Rien de ce qu'elle a écrit ne renvoie à 526 d'entre eux.
En mai, ma mère m'a envoyé une affiche qu'elle avait faite : un cimetière au crépuscule, six pierres tombales portant les titres de ses propres textes, et sa phrase en haut, ne traitez pas vos contenus comme un cimetière, traitez-les comme une bibliothèque. Elle demandait tous ses textes au même endroit, et quelque chose qui l'y ramène quand elle commence un nouveau texte. Je lui ai plutôt bâti un planificateur de publications. Cette fin de semaine, j'ai bâti ce qu'elle avait vraiment demandé : une page, 710 textes, et un modèle ouvert qui tourne dans son onglet pour que ses brouillons ne quittent jamais son portable. Elle l'a corrigé sans le savoir, parce que le corrigé, ce sont tous les liens qu'elle a faits à la main entre 2011 et 2026.