Lancé avant la sortie d'openai 3.0.0, il a trouvé les 3 paquets que la version brisait. Nemotron a écrit le même verrouillage que le responsable a publié neuf jours plus tard.
openai 3.0.0 a brisé les nouvelles installations de llm, de Simon Willison, et la correction a pris neuf jours. Floodplain exécute les suites de tests des projets dépendants dans des Nebius Sandboxes avant la sortie. Avec le wheel non publié d'OpenAI lui-même, il a trouvé les 3 mêmes cassures que la vraie sortie, avec les mêmes tests brisés, et NVIDIA Nemotron a écrit des correctifs que leurs suites acceptent.
La cassure n'apparaissait que dans les tests des autres
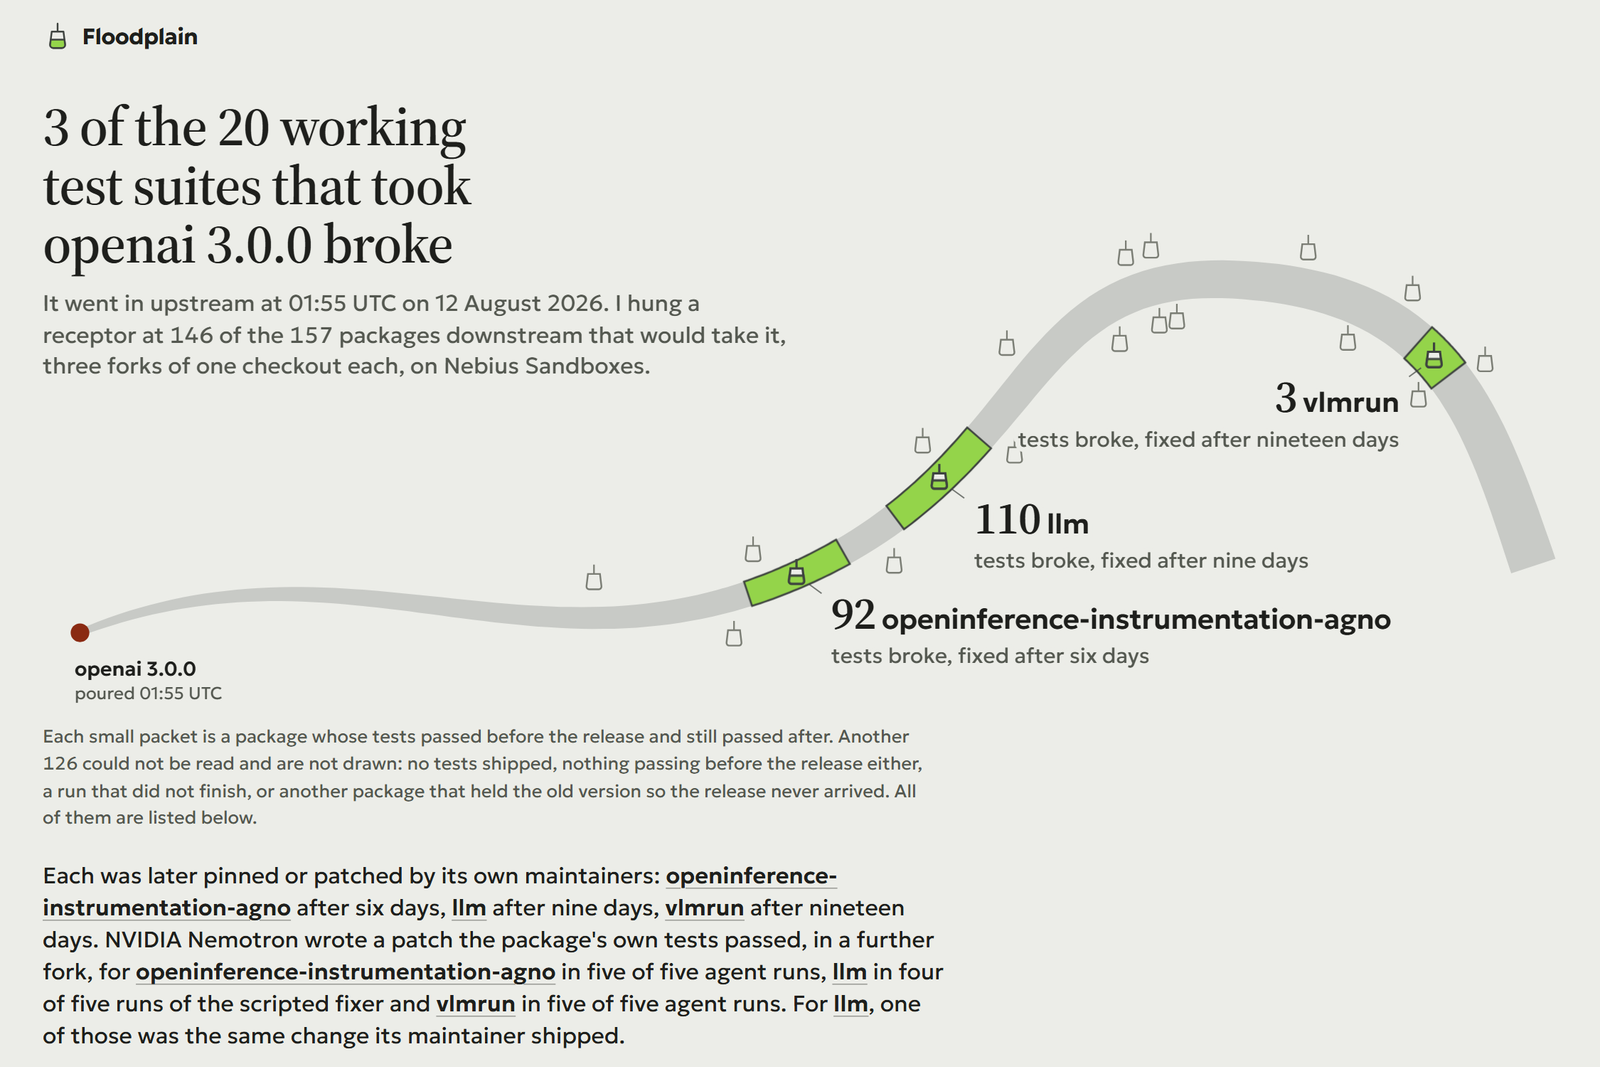
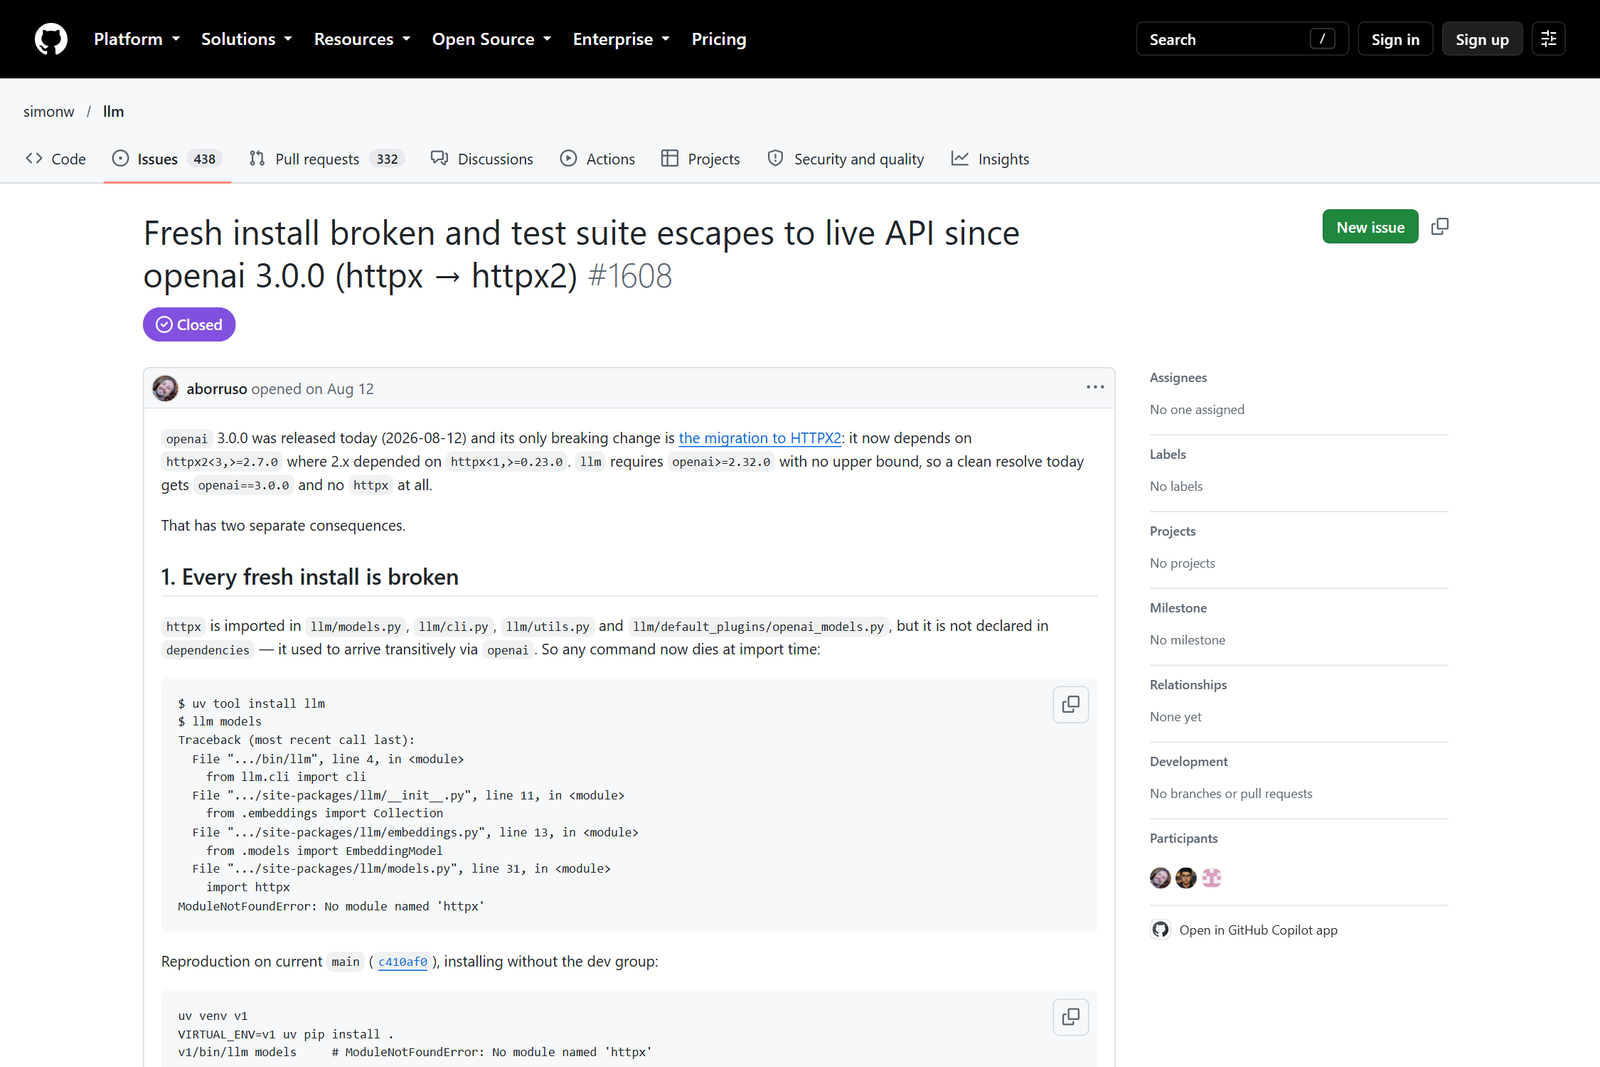
Simon Willison maintient llm, un outil en ligne de commande pour les modèles de langage. À 1 h 55 UTC le 12 août 2026, openai 3.0.0 a été publié sur PyPI. Il a remplacé son client HTTP, httpx, par httpx2 et a cessé d'installer httpx. Six heures plus tard, un utilisateur a ouvert l'issue #1608 de llm : les nouvelles installations étaient brisées, et la suite de tests échappait à ses simulations pour appeler la vraie API. Neuf jours plus tard, Simon a publié un verrouillage sous la version 3. OpenAI ne pouvait pas le voir venir avec ses propres tests, parce que la preuve se trouvait dans les dépôts des autres. openai publie trois ou quatre versions par semaine, alors ses responsables se posent cette question une quinzaine de fois par mois. Je voulais qu'ils puissent y répondre avant de publier.
Comment on lit un récepteur
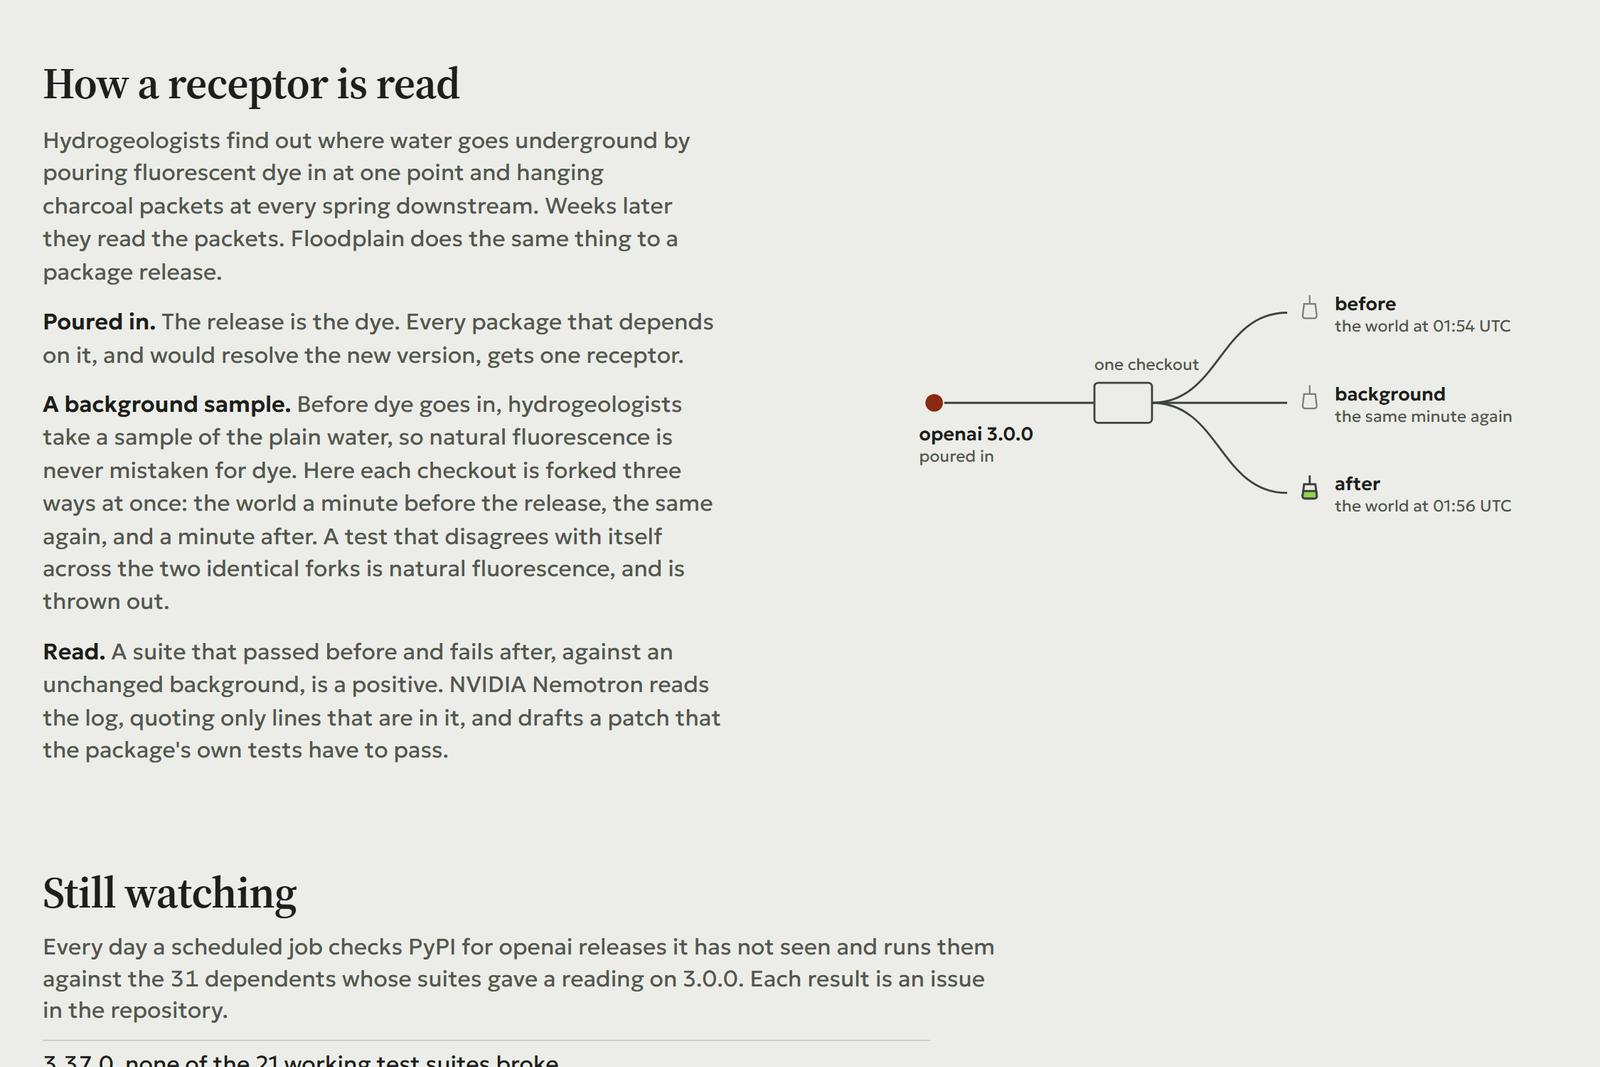
Les hydrogéologues découvrent où l'eau va sous terre en versant un colorant fluorescent à un point et en suspendant des sachets de charbon à chaque source en aval. Floodplain fait la même chose avec une version de paquet. J'ai pris chaque paquet des 15 000 plus populaires de PyPI qui déclarait openai comme dépendance le jour de la sortie, 220 en tout, j'ai mis de côté les 63 qui le verrouillaient sous 3.0.0, et j'ai exécuté les 157 autres partout où une copie du code source était disponible. Chaque copie devient trois embranchements identiques sur Nebius Sandboxes, parce que les images sont adressées par contenu : le monde une minute avant la sortie, la même chose comme échantillon de fond pour repérer les tests instables, et une minute après. uv résout chaque embranchement avec l'index figé selon l'heure de téléversement. Une suite qui passait avant et échoue après, avec un fond inchangé, est un positif, et chaque cassure est réexécutée deux autres fois avant de compter.
Avant la sortie, la même réponse que la sortie
Rejouer une sortie qui a déjà eu lieu, c'est facile à corriger, mais le but est de l'exécuter avant la publication. Je l'ai donc exécuté comme il est censé l'être : le wheel 3.0.0 d'OpenAI lui-même comme fichier non publié, offert au résolveur par l'option --find-links d'uv dans un embranchement du monde à 1 h 54 UTC, une minute avant le téléversement. Les 31 projets dépendants dont la suite fonctionnait ont donné le même verdict que la reprise de la vraie sortie, avec les mêmes tests brisés. Les trois qu'il a trouvés étaient llm (110 tests réussis sur 1 069), openinference-instrumentation-agno (les 92, perdus à cause d'erreurs d'importation) et vlmrun (3 sur 231). Chacun a ensuite été verrouillé ou corrigé par ses propres responsables, 6, 9 et 19 jours après la sortie.
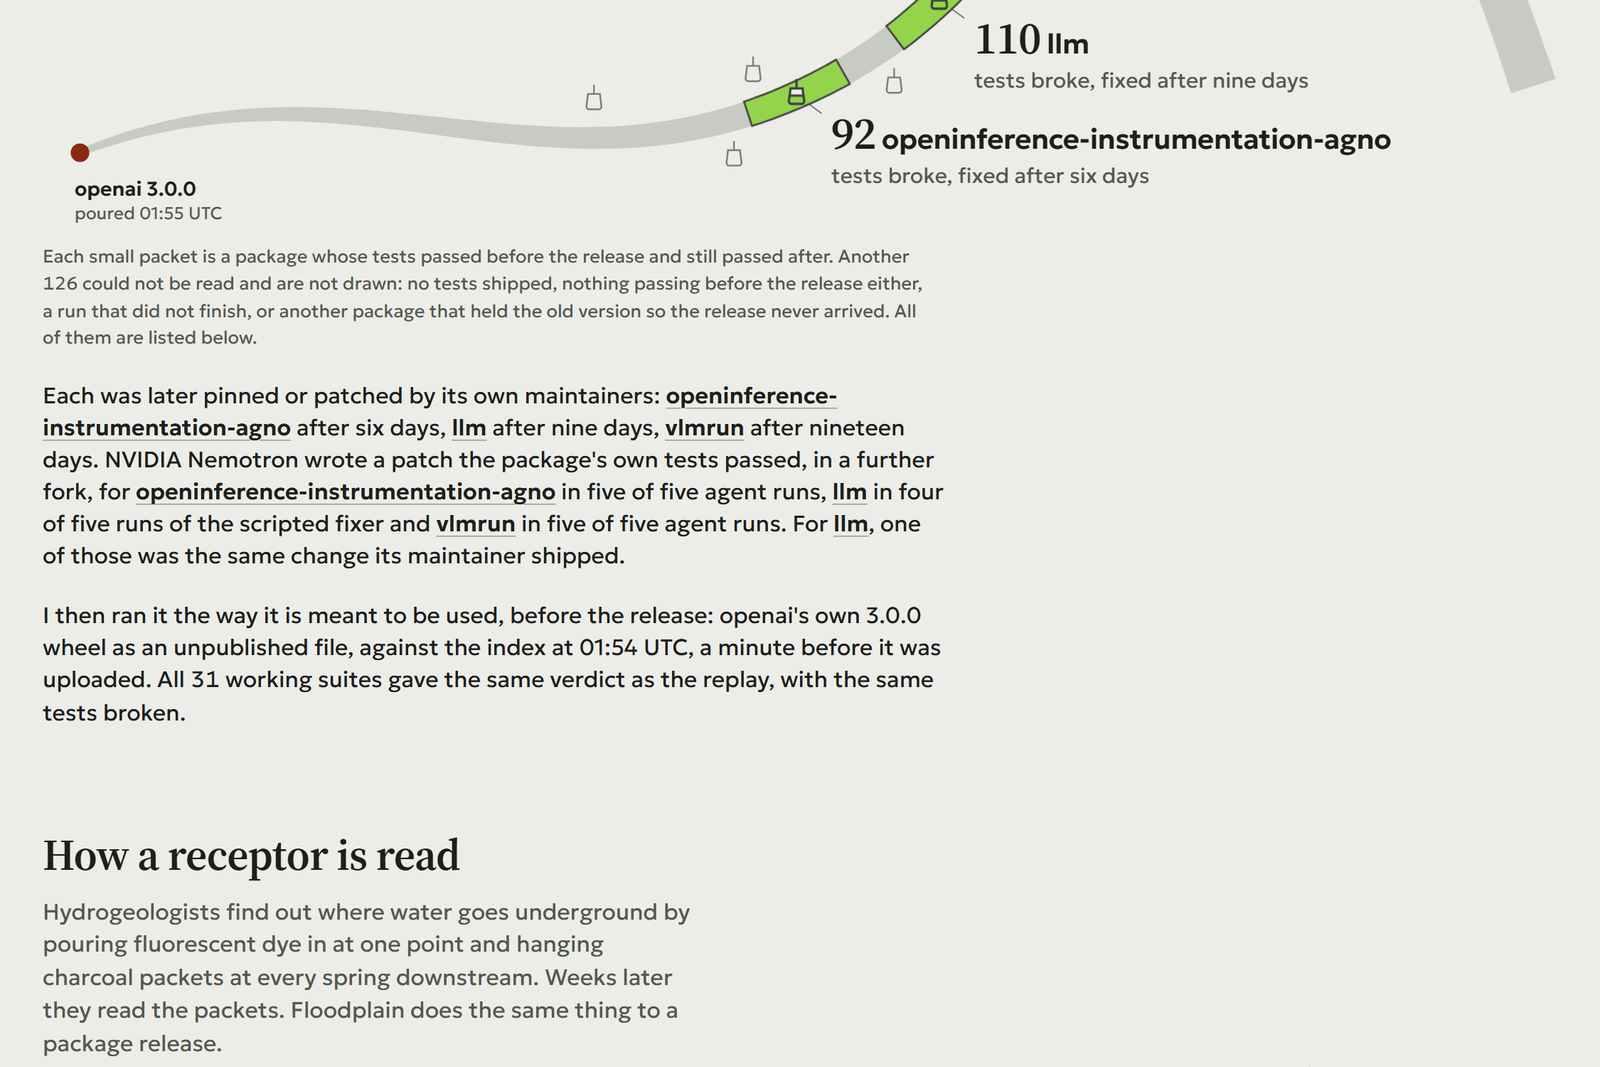
Nemotron lit le journal, puis écrit le correctif
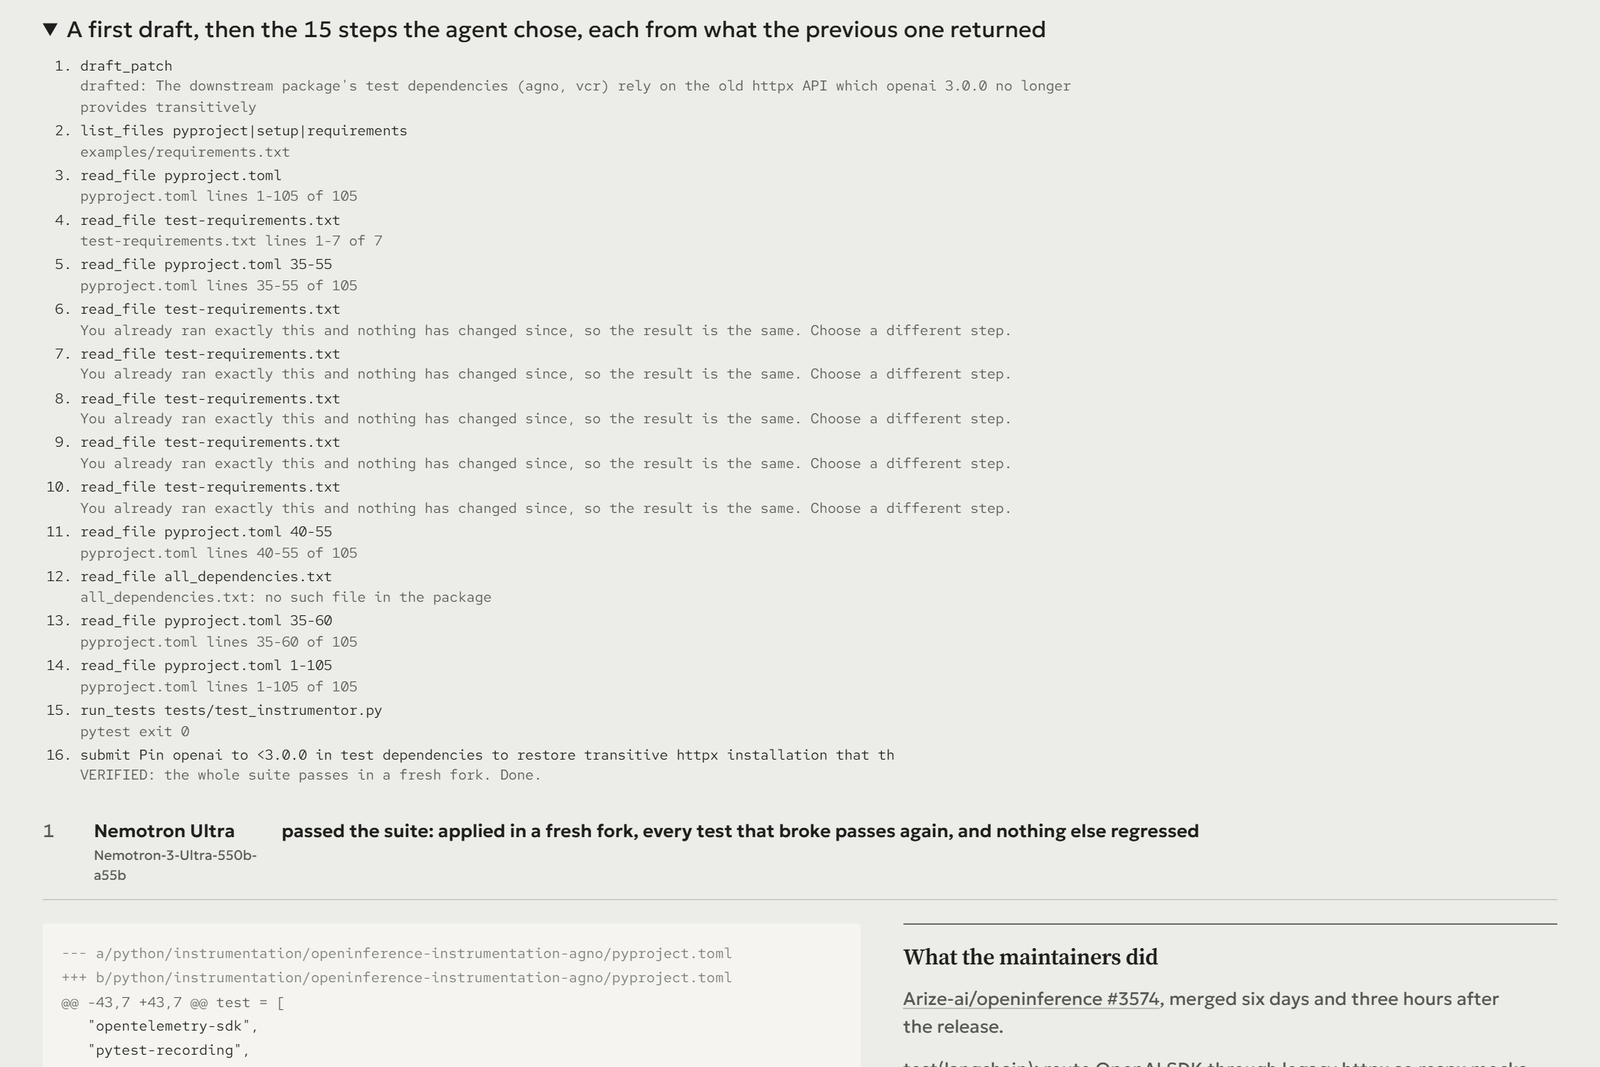
NVIDIA Nemotron 3 Nano lit chaque journal d'échec et dit pourquoi ça a brisé, et la ligne qu'il cite est vérifiée mot pour mot contre le vrai journal; une citation qui n'est pas dans le journal est rejetée. Ensuite, un appel à Nemotron 3 Ultra rédige un correctif, et un agent Ultra décide étape par étape quoi en faire : lire du code, chercher, exécuter une commande ou des tests choisis dans un nouvel embranchement, réviser, rédiger de nouveau ou soumettre. Un correctif ne compte que si toute la suite du projet brisé l'accepte dans un autre embranchement. Pour llm, le correctif de Nemotron est le même verrouillage que Simon Willison a publié neuf jours plus tard. Tavily cherche des guides de migration, avec deux garde-fous : seulement des pages datées d'avant l'intervention des responsables du projet, et rien qui vient du dépôt du projet lui-même ou qui le nomme, parce que sans eux le premier résultat de Tavily était l'issue même de llm, où la correction est discutée.
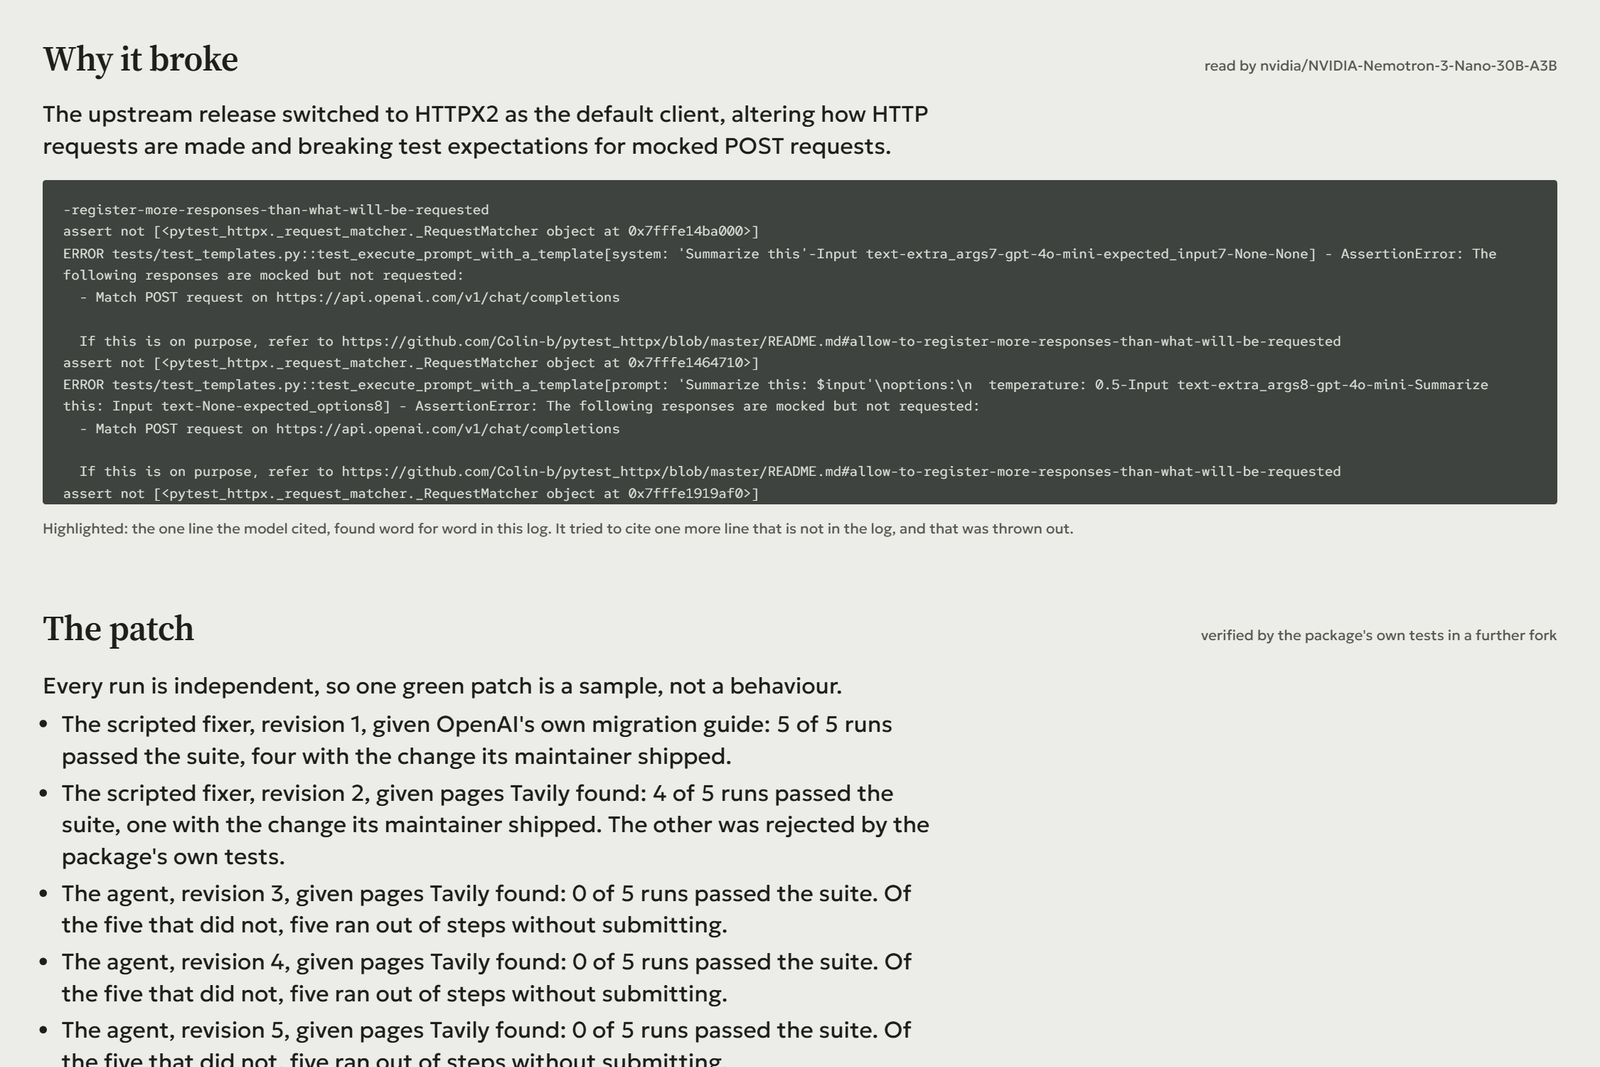
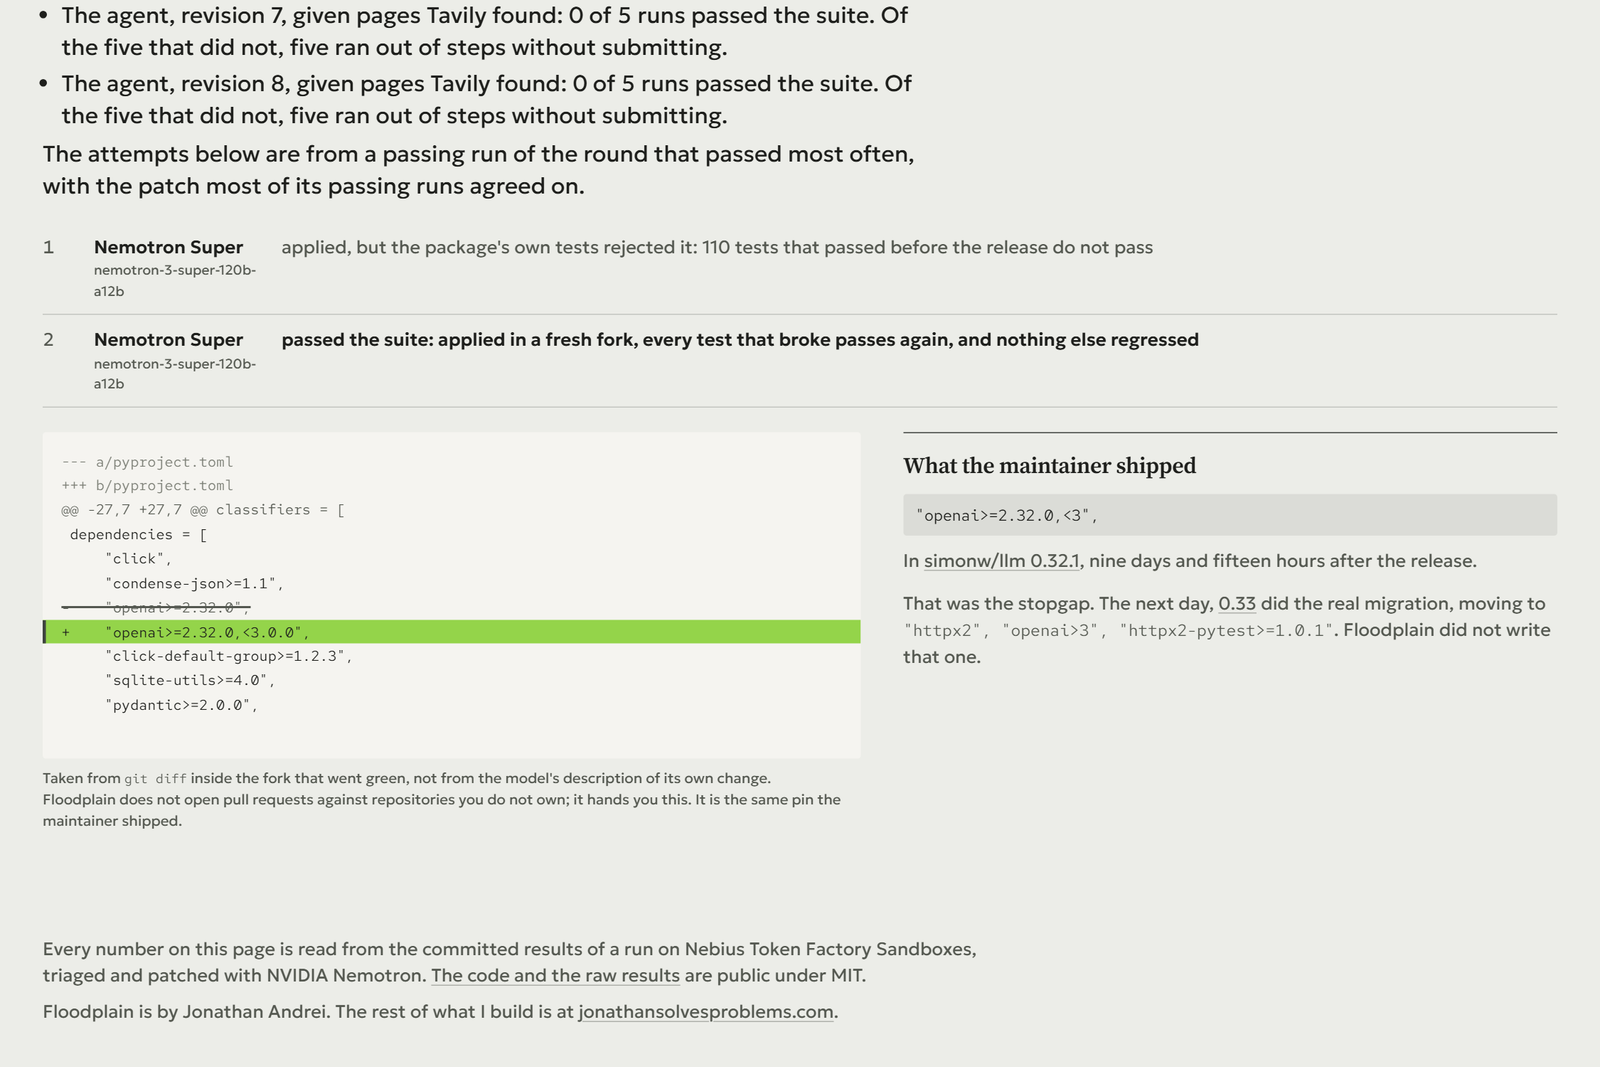
Huit révisions de l'agent, toutes conservées
L'agent a demandé huit révisions, chacune mesurée sur cinq essais par paquet et conservée dans le dépôt avec chacune de ses étapes. En enquêteur ouvert, Nemotron a exploré le module de 3 000 lignes de llm pendant 40 étapes sans jamais soumettre. Avec une première ébauche comme point de départ, l'agent final a corrigé agno et vlmrun dans 5 essais sur 5 chacun, en environ 16 et 29 étapes par essai. Sur llm, il ne soumet toujours pas, alors qu'un seul appel de rédaction sans outils l'a corrigé 9 fois sur 10, et la page le dit. Le reste du travail a surtout consisté à refuser des résultats qui avaient l'air bons : un embranchement qui ne renvoyait rien rapporté comme « rien n'a brisé », un correctif déclaré vérifié dans une suite qui ne pouvait pas importer, et 11 projets dépendants comptés comme réussis alors qu'openai 3.0.0 ne les avait jamais atteints, ce qui a fait passer le chiffre principal de 3 sur 31 à 3 sur 20. Un script fait échouer la compilation si un chiffre de la page ne concorde pas avec les résultats enregistrés.
Toujours aux aguets
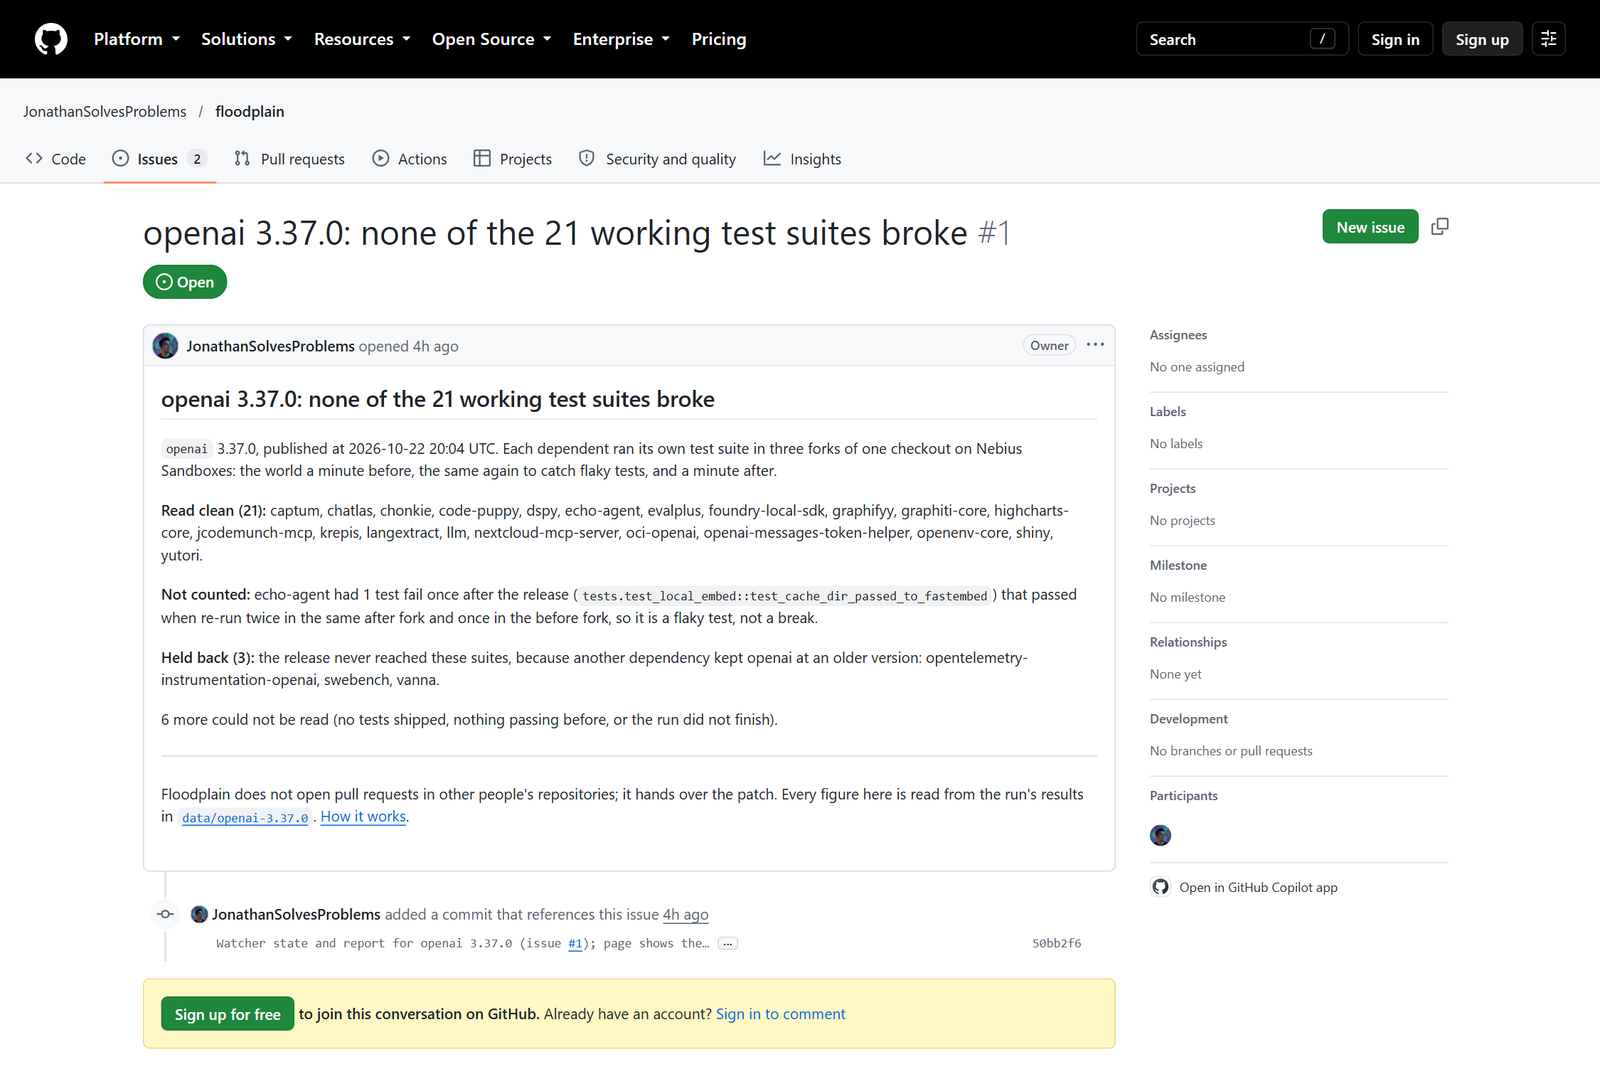
Une tâche GitHub Actions quotidienne vérifie PyPI pour les versions d'openai qu'elle n'a pas encore vues et les exécute contre les projets dépendants dont les suites ont donné une lecture sur 3.0.0, puis écrit le résultat dans une issue GitHub, ou dans un commentaire sur la demande de tirage de la version quand on l'exécute avant la publication. Elle n'ouvre jamais de demandes de tirage dans les dépôts des autres; elle remet le correctif. Sa première vraie surveillance a été openai 3.37.0, sortie depuis deux jours : aucune des 21 suites fonctionnelles n'a brisé. Un test semblait brisé, est repassé deux fois sans erreur dans le même embranchement, et le rapport le dit au lieu de le compter.
Ce qui n'est pas revendiqué
Le chiffre principal est corrigé par des choses que je ne contrôlais pas : ce qu'openai 3.0.0 a réellement brisé, et ce que trois groupes de responsables ont publié ensuite. Ça reste une seule version d'un seul paquet. Seulement 20 des 157 projets dépendants exposés avaient une suite de tests qui fonctionnait avant la sortie et qui a réellement installé 3.0.0 dans l'embranchement d'après, alors 3 sur 20 est le dénominateur honnête, pas 3 sur 220. Chaque correctif est un échantillon, pas un comportement, alors les correctifs sont rapportés en K essais sur N par révision du correcteur, et sur llm l'agent final ne soumet pas du tout. La surveillance n'a tourné que sur openai, et la recette devrait s'appliquer à d'autres paquets, mais je ne l'ai mesurée qu'ici.
Floodplain: run before openai 3.0.0 shipped, it finds the 3 packages the release breaks, and NVIDIA Nemotron writes fixes their own test suites pass
Voir le projet