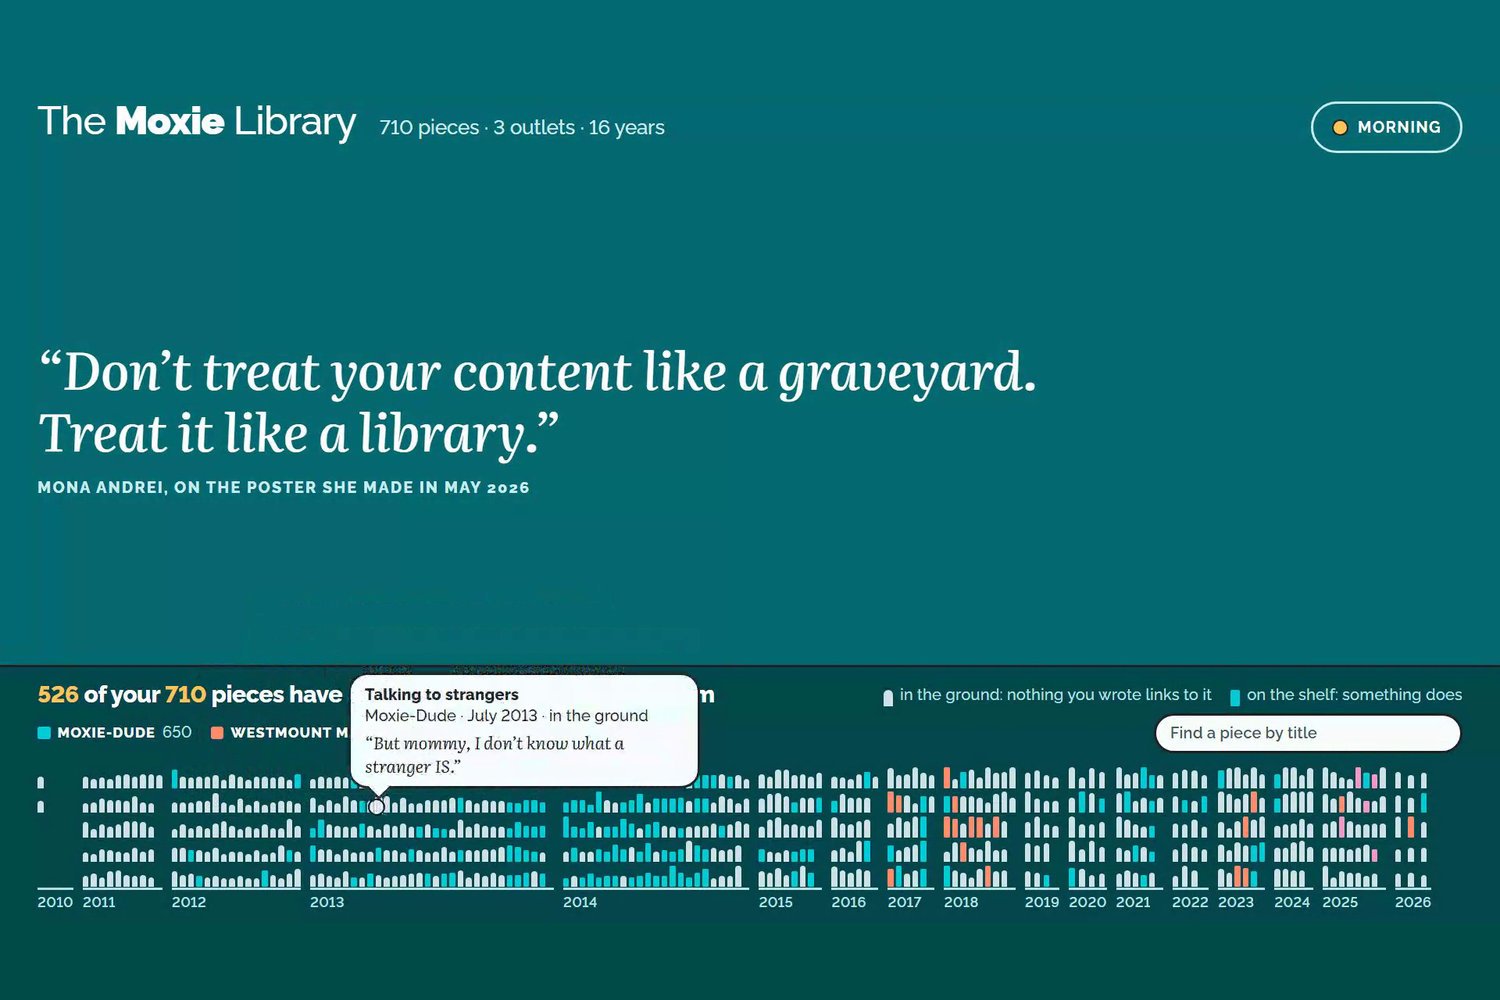
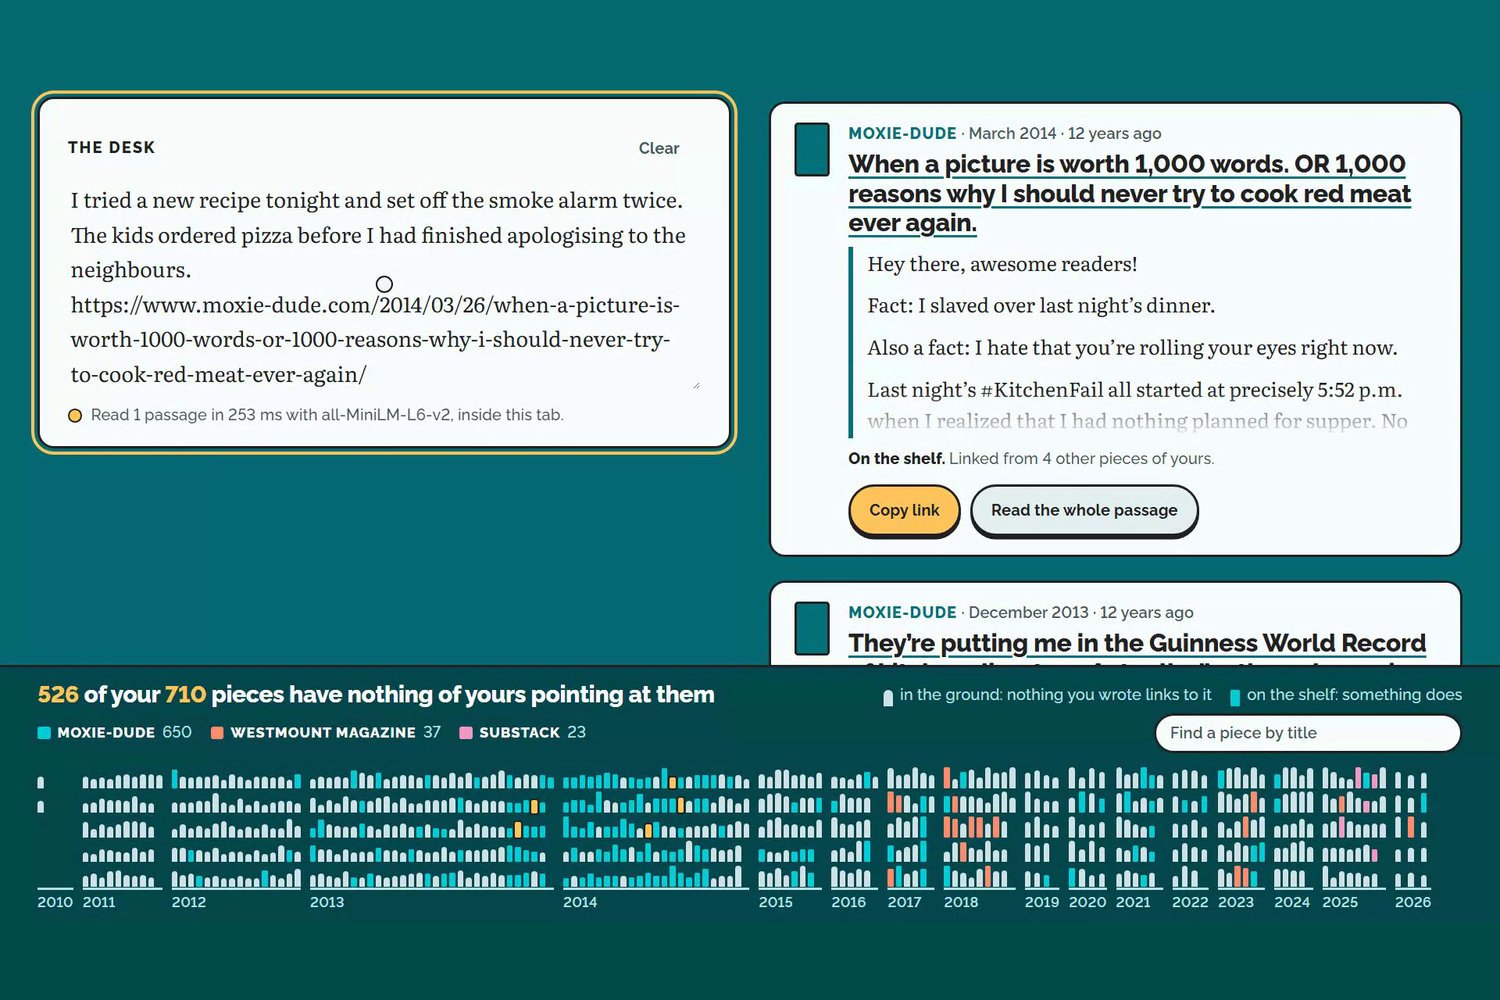
Ma mère a publié 710 textes en 16 ans. Rien de ce qu'elle a écrit ne renvoie à 526 d'entre eux.
En mai, ma mère m'a envoyé une affiche qu'elle avait faite : un cimetière au crépuscule, six pierres tombales portant les titres de ses propres textes, et sa phrase en haut, ne traitez pas vos contenus comme un cimetière, traitez-les comme une bibliothèque. Elle demandait tous ses textes au même endroit, et quelque chose qui l'y ramène quand elle commence un nouveau texte. Je lui ai plutôt bâti un planificateur de publications. Cette fin de semaine, j'ai bâti ce qu'elle avait vraiment demandé : une page, 710 textes, et un modèle ouvert qui tourne dans son onglet pour que ses brouillons ne quittent jamais son portable. Elle l'a corrigé sans le savoir, parce que le corrigé, ce sont tous les liens qu'elle a faits à la main entre 2011 et 2026.
Tu te souviens de mon idée d'application ?
Ma mère s'appelle Mona Andrei. Elle écrit de l'humour. Elle tient un blogue appelé Moxie-Dude depuis 2010, elle signe une chronique dans Westmount Magazine, elle anime une infolettre Substack pour les mères monoparentales, et elle a écrit un livre intitulé Superwoman. En mai, elle m'a envoyé une affiche qu'elle avait faite : un cimetière au crépuscule, six pierres tombales, et sur chacune le titre d'un de ses textes et le média où il avait paru. En haut, sa propre phrase. En dessous, elle avait tapé : « Tu te souviens de mon idée d'application ? » Elle voulait deux choses. Tous ses textes au même endroit, et quelque chose qui la ramène vers ce qu'elle a déjà écrit quand elle s'assoit pour en écrire un nouveau. Je lui ai bâti un planificateur de publications. Il avait une page d'accueil, un logo, et il tournait sur des données d'exemple. Elle a trouvé un produit en ligne qui faisait déjà ça et m'a écrit : « Trouvé. Je vais trouver le trou. » Cette fin de semaine, j'ai bâti ce qu'elle avait demandé la première fois.
Son cimetière, compté
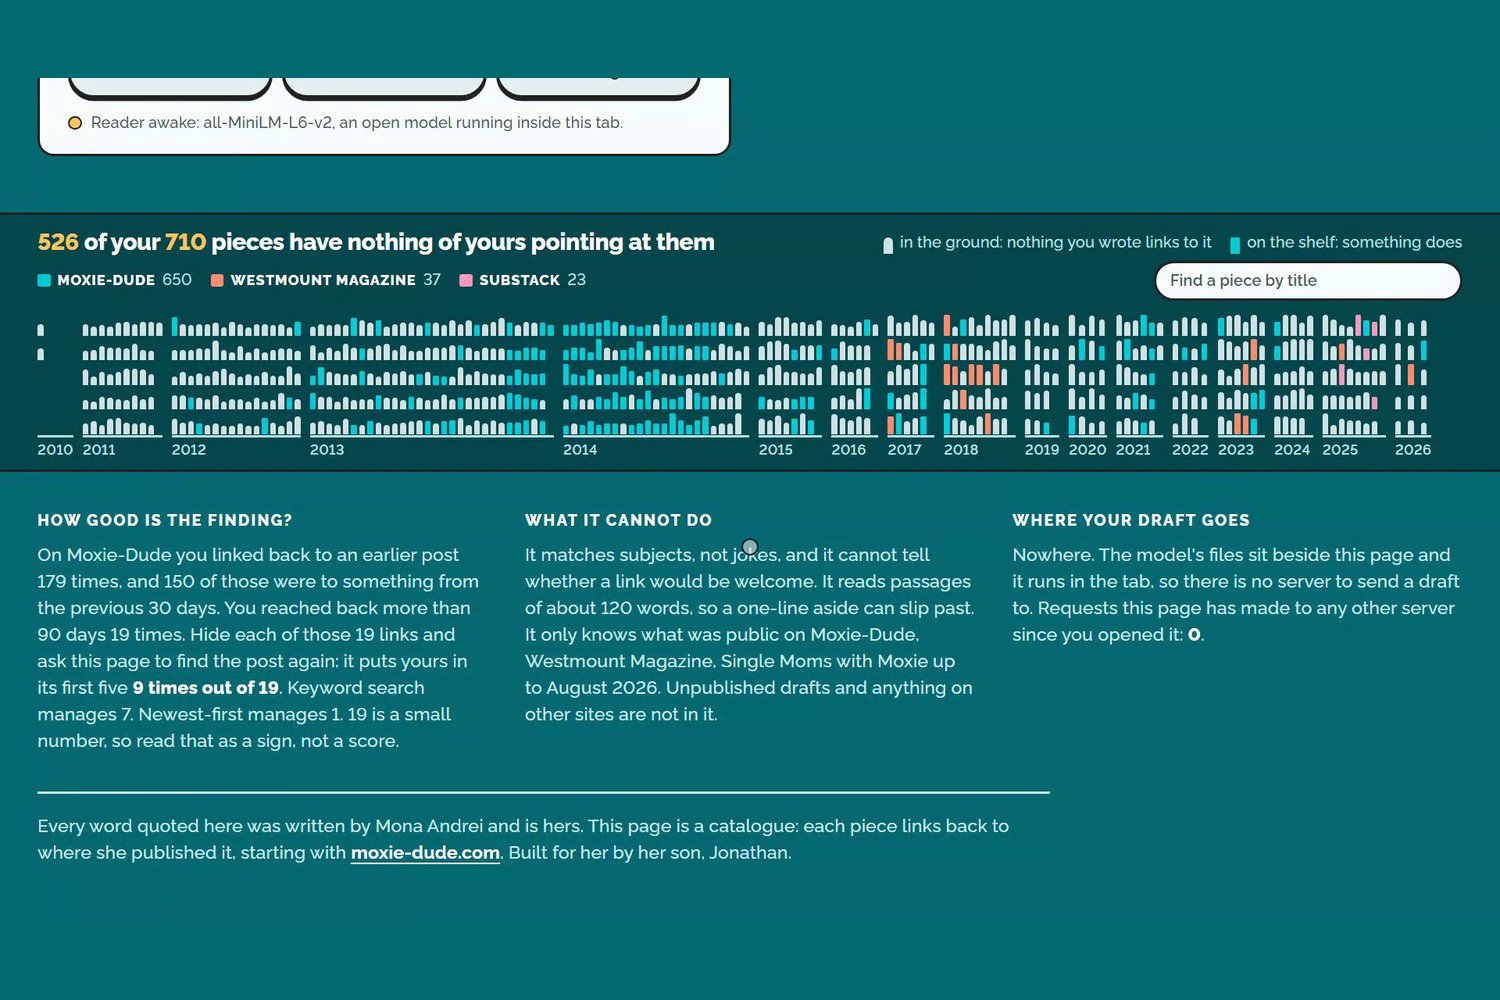
J'ai récupéré tout ce qui est public : 650 billets de son blogue, 37 chroniques de Westmount Magazine et 23 textes de son Substack. Ça fait 710 textes et 353 232 mots, découpés en 2 809 passages d'environ 120 mots chacun. Puis j'ai compté les liens qu'elle avait faits à la main d'un de ses textes vers un autre. 526 des 710 n'ont rien d'elle qui pointe vers eux. Sur son blogue, elle a renvoyé à un billet antérieur 179 fois, et 150 de ces renvois pointent vers quelque chose des 30 derniers jours. En seize ans, elle est remontée à plus d'un an neuf fois. Laissée à sa mémoire, une autrice fait des liens vers ce qu'elle a écrit la semaine dernière. L'affiche avait raison, et plus raison qu'elle ne le croyait : trois des six textes sur ses pierres tombales sont dans la bibliothèque, et les trois sont dans le sol.
Le bureau
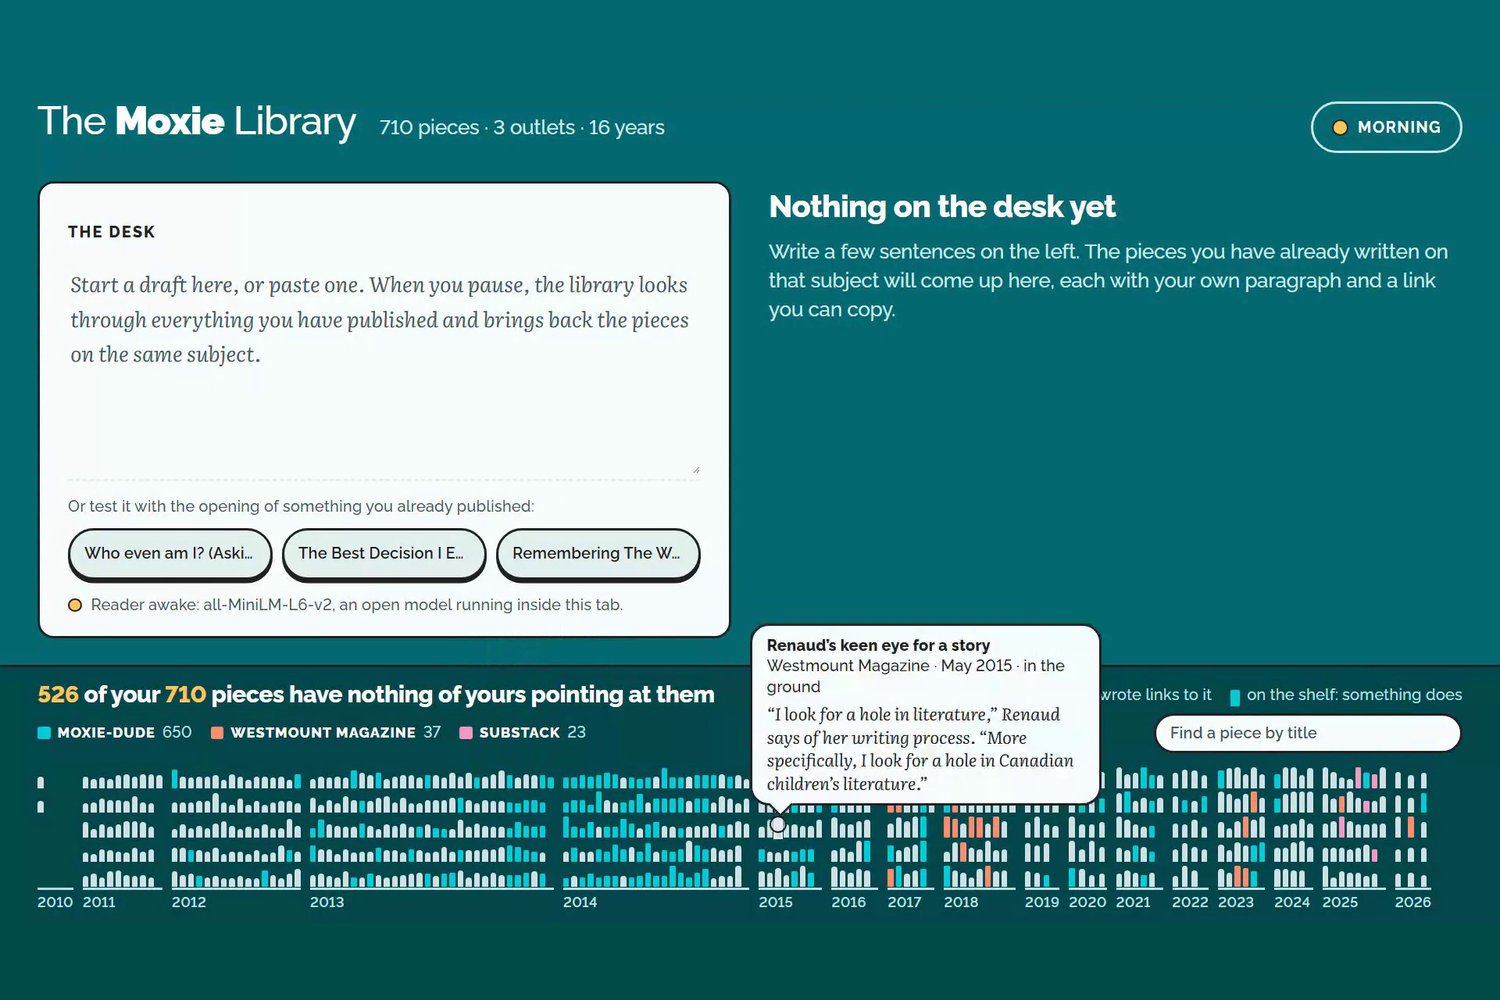
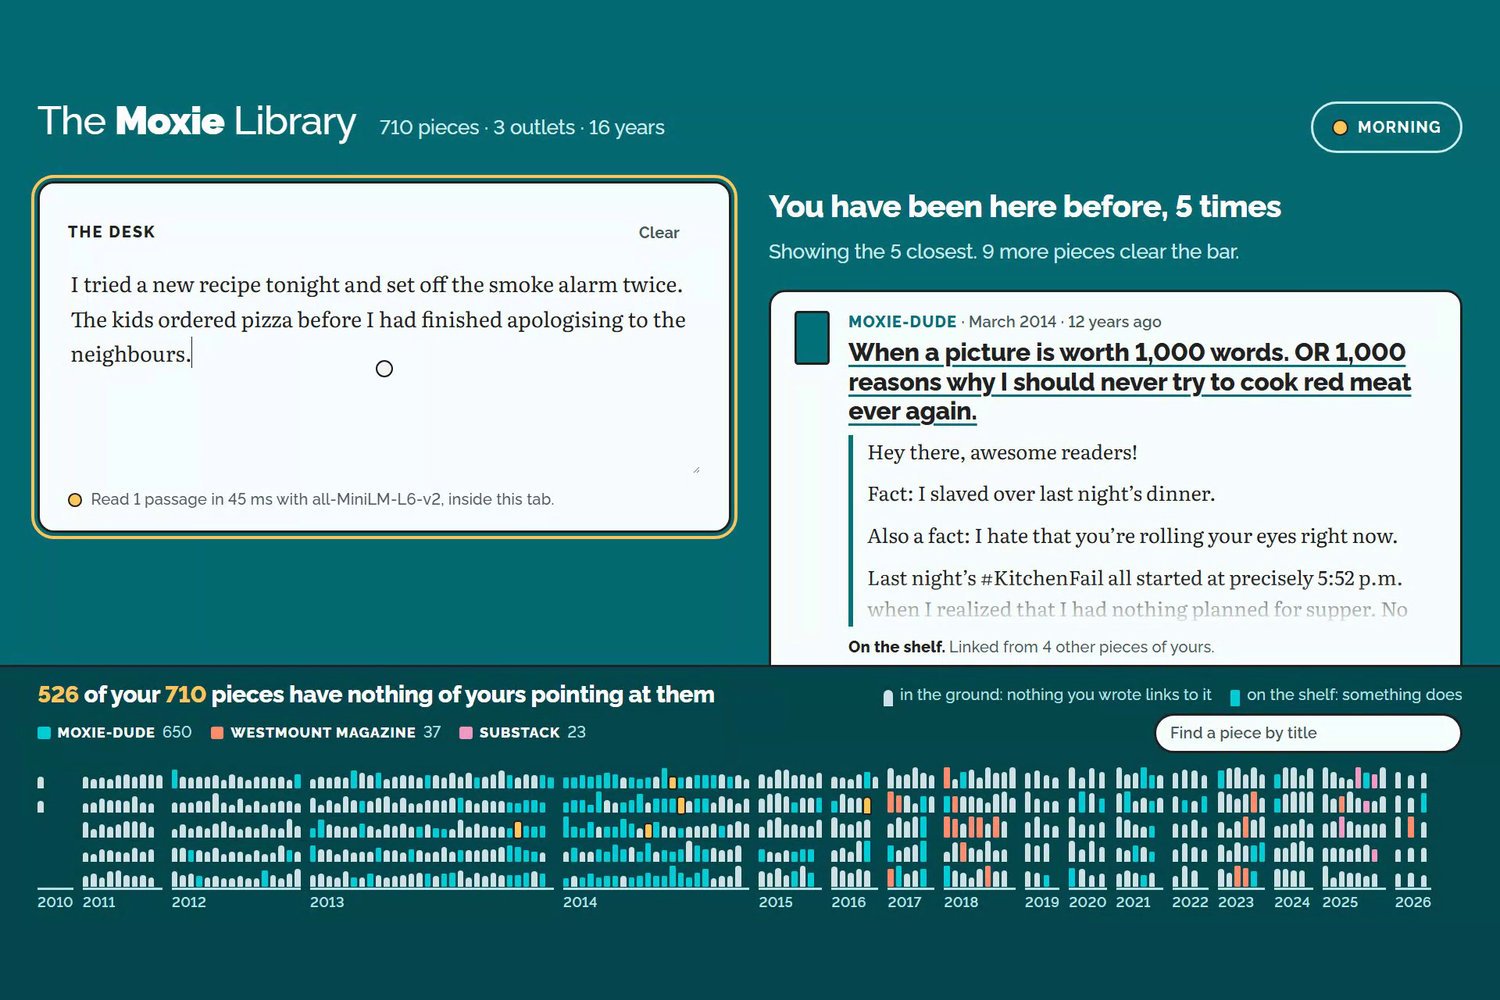
À gauche, une feuille de papier. Elle y écrit un brouillon, ou en colle un. Quand elle s'arrête, le brouillon est découpé en passages de la même façon que ses textes publiés, chacun est vectorisé dans l'onglet, et chaque texte qu'elle a publié est noté par son passage le plus proche. C'est tout le mécanisme d'appariement. Ce qui revient, ce sont cinq de ses propres textes, chacun avec son propre paragraphe cité, le média, le nombre d'années écoulées, et un bouton qui copie un lien à coller directement dans WordPress ou Substack. Dans l'enregistrement, j'ai tapé deux phrases sur un détecteur de fumée déclenché et une pizza commandée. Ce sont mes phrases de test, pas les siennes. Ce qui revient est d'elle : cinq textes écrits entre 2013 et 2016, à commencer par celui qui explique pourquoi elle ne devrait plus jamais essayer de cuire de la viande rouge. Rien sur la page n'est écrit à sa place. Chaque suggestion est un vrai lien et un passage découpé dans sa propre prose.
Elle a écrit le corrigé sans le savoir
C'est la partie qui me tient le plus à coeur, parce que le correcteur n'est pas moi. Le corrigé, ce sont tous les liens qu'elle a faits à la main entre 2011 et 2026. Le test prend un billet où elle renvoyait à un texte antérieur, retire le lien et son texte, traite le reste comme un brouillon, demande le classement de tous les textes antérieurs par proximité, et regarde où tombe celui qu'elle a réellement cité. La plupart de ses liens ne testent en rien la mémoire, parce que 150 sur 179 pointent vers les 30 derniers jours et qu'un simple classement du plus récent les trouve. Les 19 qui remontent à plus de 90 jours sont ceux qui comptent. Le plus récent d'abord place sa vraie cible dans les cinq premiers une fois. La recherche par mots-clés en obtient 7. Le modèle embarqué dans la page en obtient 9. Dix-neuf, c'est peu, et neuf contre sept n'est pas un écart que je défendrais, ce que la soumission dit exactement. J'ai aussi essayé de fusionner le modèle avec la recherche par mots-clés, ce qui donnait 10, et je n'ai pas livré un second classeur pour un succès de plus. Tous ces chiffres sortent des vecteurs exacts que la page charge, pas d'une exécution distincte.
Elle dit quand il n'y a rien
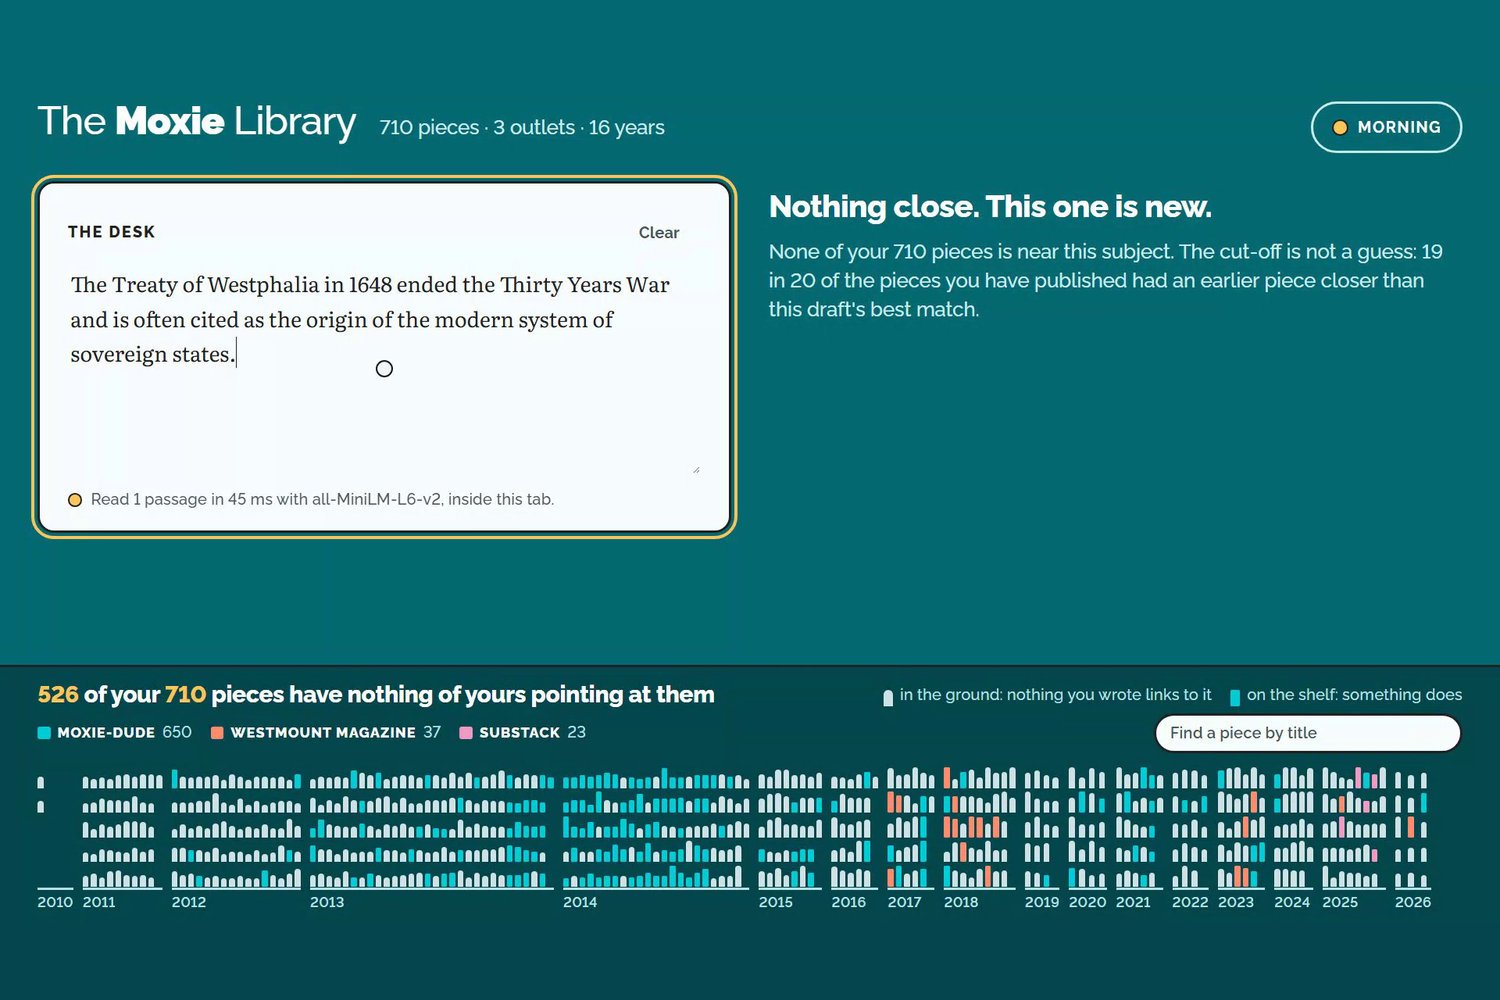
Si elle écrit sur un sujet qu'elle n'a jamais abordé, la page dit que le sujet est nouveau et n'affiche rien, au lieu de remplir la liste avec les cinq correspondances les moins mauvaises. Pour bien régler cette règle, il a fallu deux tentatives et la première ne valait rien. Mon premier seuil était un niveau de similarité que neuf de ses vrais liens sur dix dépassaient, ce qui semble raisonnable et ne l'est pas, parce que le passage sans rapport le plus proche obtient d'habitude un meilleur score que le billet qu'elle a réellement cité : la page n'aurait donc jamais rien refusé. La règle livrée vient plutôt de ses archives : pour chaque texte qu'elle a publié, à quelle distance se trouvait le texte antérieur le plus proche ? Dix-neuf sur vingt dépassent un certain niveau. Un brouillon sous ce niveau est plus loin de son travail passé que presque tout ce qu'elle a publié, et c'est là que la page dit que le sujet est nouveau. C'est une règle tirée de ses propres écrits, pas une garantie.
Son brouillon ne quitte jamais l'onglet
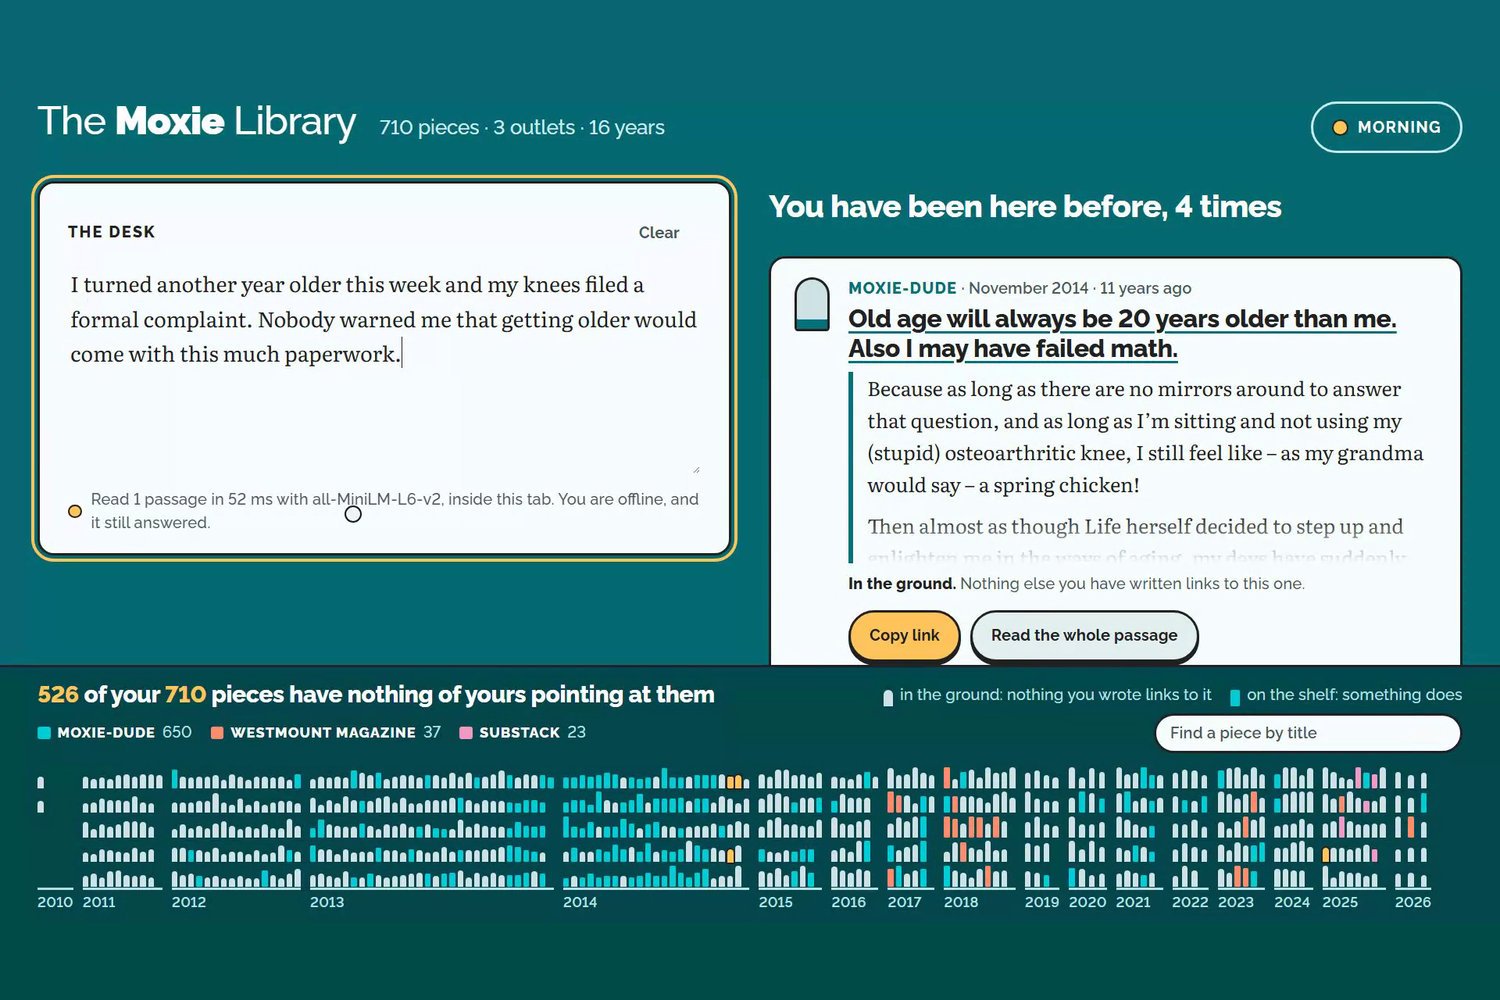
Un brouillon non publié est la seule chose qu'une autrice ne confie pas à un serveur qu'elle ne contrôle pas, et ici il n'y a aucun serveur à qui le confier. Le modèle est all-MiniLM-L6-v2, à poids ouverts, 23 Mo en 8 bits, qui tourne par transformers.js sur WebAssembly dans un web worker à l'intérieur de son onglet. Ses fichiers sont posés à côté de la page plutôt que sur un CDN. Tout l'index de ses textes représente 2 809 vecteurs de 384 nombres chacun, stockés à un octet par nombre, soit 1,08 Mo. La page compte ses propres requêtes vers toute autre origine et affiche le nombre en bas : il est à 0. Coupez le Wi-Fi et elle répond quand même, ce qui n'est pas une promesse dans un README mais une vérification dans un vrai Chromium qui met le navigateur hors ligne et redemande. Elle ne coûte rien à faire tourner, ce qui compte plus qu'il n'y paraît, parce que ma mère ne paiera pas d'abonnement mensuel pour fouiller ses propres textes et que je ne paierai pas à la requête pour qu'elle puisse le faire.
Une ligne par texte, gardée seulement si elle est mot pour mot la sienne
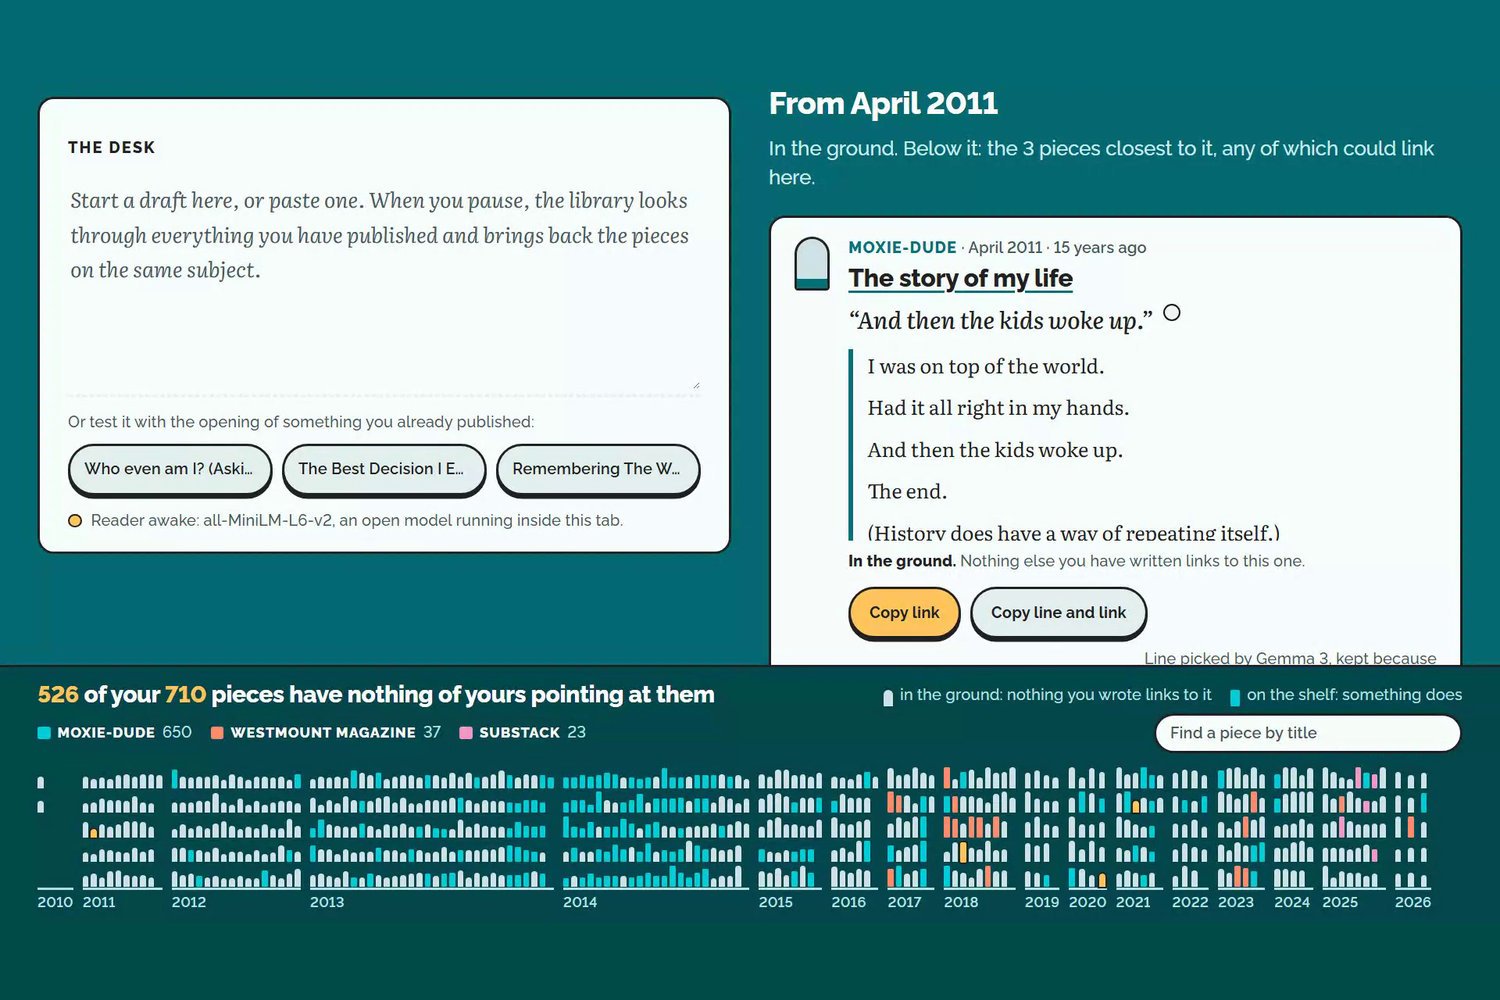
Un second modèle ouvert choisit la phrase la plus digne d'être citée dans chaque texte. Gemma 3 4B, en local par Ollama, lit un texte et propose une ligne. Puis une comparaison de chaînes tranche, et le modèle n'a pas voix au chapitre : la ligne n'est gardée que si on la retrouve mot pour mot dans ce texte, et ce qui est stocké est l'extrait découpé dans sa prose plutôt que la retranscription de Gemma. Il a été interrogé sur 694 textes. 560 lignes ont été gardées, dont 131 seulement après une correction. 134 ont été rejetées : 23 n'étaient pas mot pour mot les siennes, 18 avaient la mauvaise longueur, 91 dépassaient la limite, et deux fois il a répondu qu'il n'y avait pas de ligne, ce qui est une réponse permise. Pour les 9 autres textes, le serveur local a renvoyé une erreur à chaque tentative, donc ils n'ont aucune ligne et la page n'en affiche simplement pas. Pour être clair sur la répartition du travail, parce que c'est facile à confondre : Gemma propose les lignes à citer, et l'appariement dans la page, c'est all-MiniLM.
Des vérifications qui échouent à voix haute
Deux scripts décident si tout cela a le droit de sortir. check_site.mjs ouvre la page dans un vrai Chromium et vérifie ce que la page promet : le modèle se charge depuis des fichiers locaux, un passage d'elle retrouve d'abord son propre texte, le passage cité est mot pour mot celui de la bibliothèque, le traité de Westphalie obtient « rien de proche », la page répond encore avec le réseau coupé, n'importe quel texte s'ouvre au clavier, et pas une seule requête ne quitte l'origine de la page. Quatorze vérifications. check_claims.py lit chaque chiffre du README et du billet de soumission et le compare aux données, et dès sa première exécution il a attrapé un nombre de mots périmé dans mon propre plan. Je rebâtis ce script sur chaque projet parce qu'un chiffre écrit un samedi et un pipeline relancé un dimanche, c'est exactement ainsi qu'un billet finit par mentir sur ses propres données, et je préfère que la compilation me le dise plutôt qu'un lecteur.
Ce qui n'est pas revendiqué
Neuf contre sept sur un échantillon de dix-neuf n'est pas un résultat, et je ne vais pas l'habiller comme tel. Ce que le test appuie est étroit : un modèle ouvert de 23 Mo dans un onglet fait au moins aussi bien que la recherche par mots-clés sur la seule chose qu'elle ne peut pas faire de mémoire, soit remonter à plus de trois mois. Il apparie des sujets, pas des blagues, et il ne peut pas dire si un lien serait le bienvenu. Il lit des passages d'environ 120 mots, donc une remarque d'une seule ligne peut lui échapper. Il ne connaît que ce qui était public sur trois médias au moment de bâtir la bibliothèque, et trois autres médias nommés sur sa propre affiche manquent parce que leurs sites ne m'ont pas laissé les lire. Le seuil pour déclarer qu'un sujet est nouveau est un niveau tiré de ses archives, pas une garantie. Je n'ai pas passé de modèle d'embeddings fermé contre ses liens, donc je ne vais pas prétendre que l'ouvert a gagné sur l'exactitude brute ; ce que l'ouvert a fait et que le fermé ne pouvait pas faire, c'est tourner dans son onglet, hors ligne, sans que son brouillon aille nulle part. Et pour savoir si elle aime ça : rien pour l'instant. Elle a accepté d'être l'exemple, mais elle ne s'est pas encore assise devant, donc il n'y a pas de citation d'elle ici. Je préfère laisser ce blanc que d'en écrire une à sa place, ce qui est aussi la règle que la page elle-même suit.
The Moxie Library: 16 years of my mom's writing in one page, searched by an open model inside her own browser tab
Voir le projet