Un agent qui refuse de mettre des mots dans la bouche de Canon : 21 citations sur 22 retrouvées mot pour mot dans les documents du fabricant
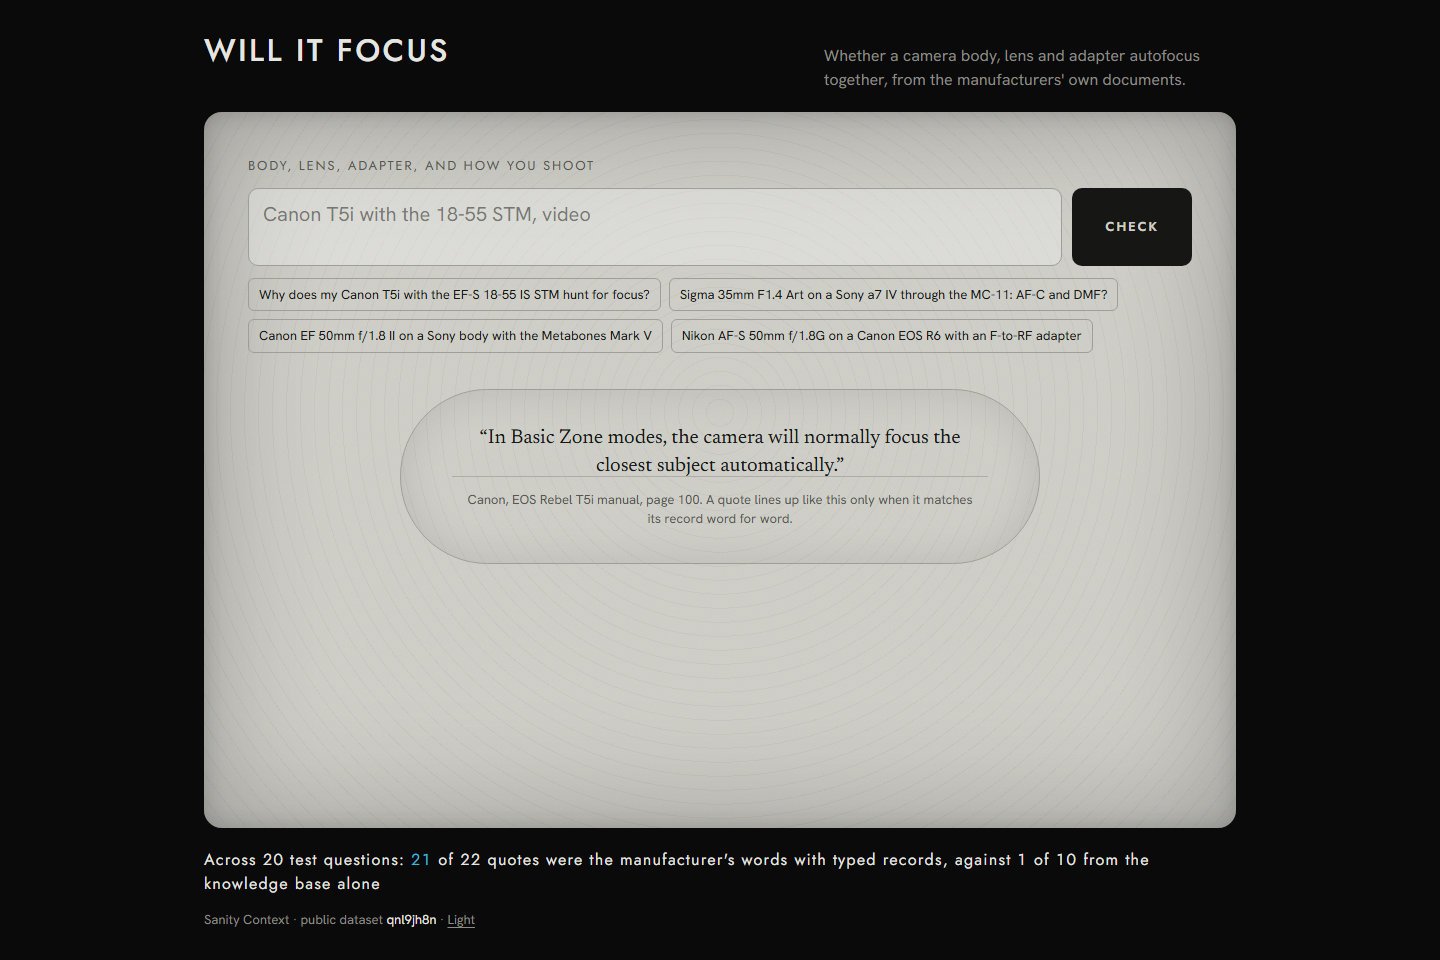
Quand je travaillais en cinéma, mon Canon T5i manquait la mise au point en mode auto et je passais en manuel. Le manuel de Canon l'explique à la page 100, et je ne l'avais jamais lu. Ce genre de question de compatibilité a des réponses publiées, difficiles à trouver et faciles à mal citer, alors Will It Focus lit les documents des fabricants et refuse de les paraphraser entre guillemets. Deux points d'accès Sanity Context, un agent sur gpt-5.4-mini : 131 fiches typées servent les verdicts, une base de connaissances bâtie sur six PDF de fabricants sert les explications, et après la réponse du modèle, le code va chercher chaque citation dans la fiche citée. Sur 20 questions corrigées par les tableaux de Sigma, de Canon et de Metabones, 21 passages cités sur 22 sont mot pour mot. La première fois que je l'ai fait tourner sur la seule base de connaissances, il a mis des guillemets autour de 13 phrases qui n'apparaissent dans aucun des six documents, et c'est toute la raison pour laquelle le texte textuel vit maintenant dans des fiches typées.
La page 100
Quand je travaillais en cinéma, mon Canon T5i avait parfois du mal à faire la mise au point en mode auto, et je finissais par abandonner, passer en manuel et la faire moi-même. L'explication était dans la boîte depuis le début. La page 100 du manuel de Canon pour cet appareil dit que dans les modes de la zone de base, l'appareil fait normalement la mise au point automatiquement sur le sujet le plus proche, et qu'il peut donc ne pas toujours faire le point sur le sujet que vous visez. Le manuel fait 388 pages, et la page 100 est celle dont j'avais besoin. C'est la forme de tout le problème. Ces questions ont des réponses publiées, écrites par le fabricant, et ces réponses sont difficiles à trouver et faciles à mal retenir. Le tableau du MC-11 de Sigma dit lesquels de ses objectifs gardent la mise au point continue sur un boîtier Sony, et pour cet adaptateur la réponse est aucun. La fiche d'instructions de Canon pour le 18-55 STM nomme les quatre boîtiers exacts sur lesquels il fait un Movie Servo AF silencieux. Personne ne lit ni l'un ni l'autre avant d'acheter l'objectif.
La base de connaissances a mis des guillemets autour de treize phrases qui n'existent pas
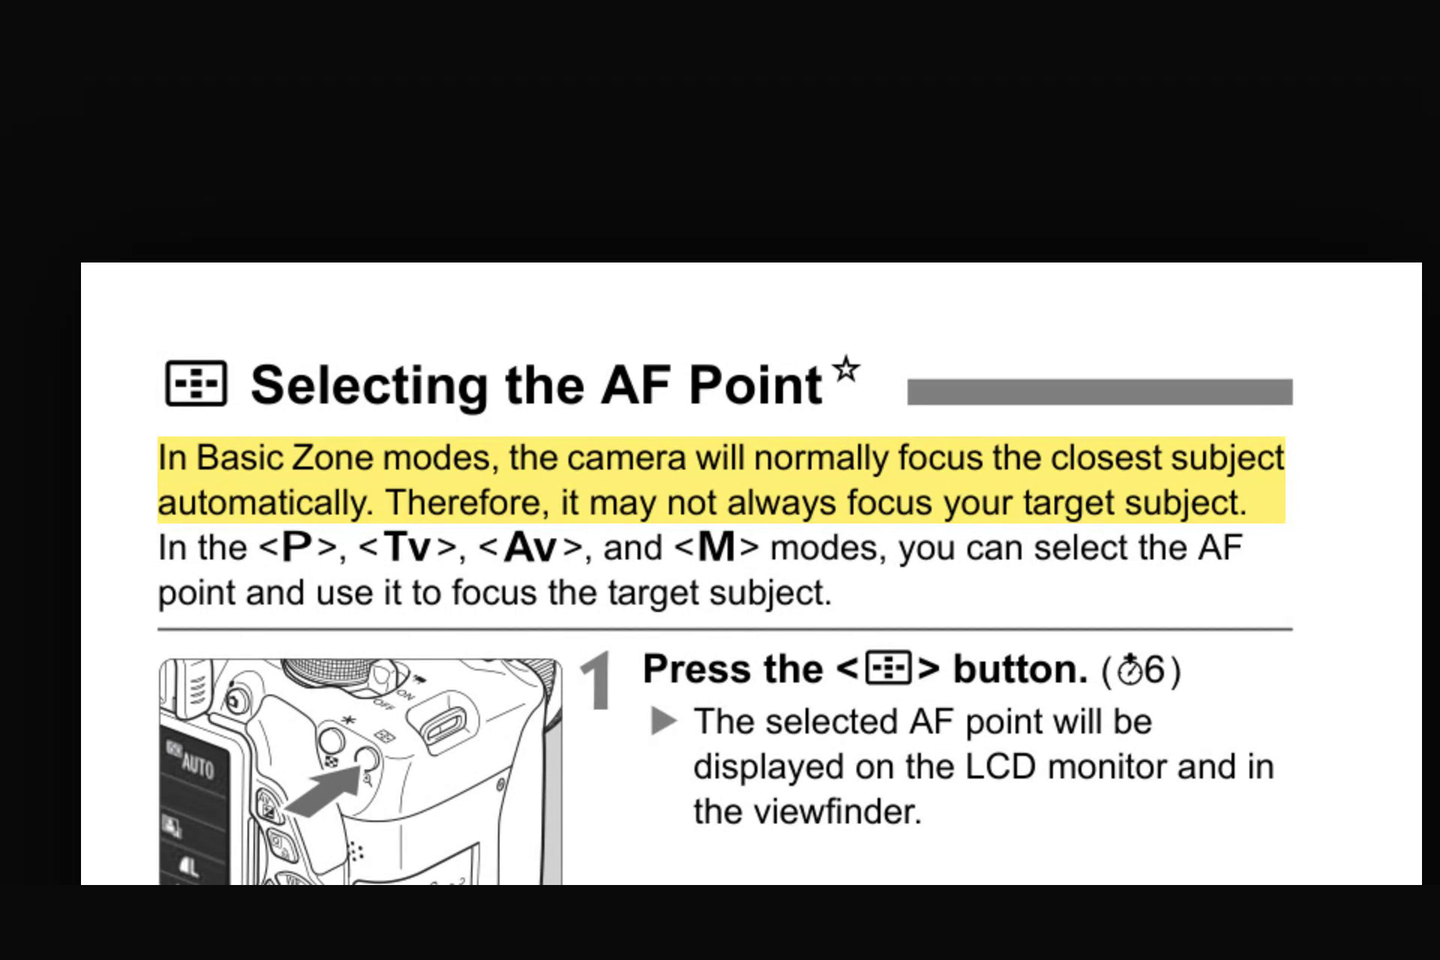
J'ai commencé avec un seul point d'accès Sanity Context et j'y ai attaché les deux sources, une base de connaissances bâtie sur six PDF de fabricants et un jeu de données typé. La première fois que j'ai fait tourner l'agent contre la seule base de connaissances, il a bien répondu et il a mis des guillemets autour de 13 phrases. Aucune de ces 13 n'apparaît dans les six documents. Ce n'est pas un défaut de la base de connaissances, c'est la base de connaissances qui fait son travail : elle a réécrit 388 pages de Canon en dix entrées navigables, et la réécriture est justement sa raison d'être. L'erreur était la mienne, celle de demander les mots exacts du fabricant à un outil de résumé. J'ai donc séparé les deux. Le point d'accès du jeu de données sert les fiches en mode GROQ et les verdicts viennent de là. Le point d'accès de la base de connaissances sert les explications, et chaque point qu'elle apporte est étiqueté sur la page comme un résumé et non comme les mots du fabricant. Enregistrer le jeu de données remplaçait la base de connaissances au lieu de s'y ajouter, et c'est ce qui a forcé la séparation en deux points d'accès, et les deux ensembles d'outils portent un préfixe pour que l'agent distingue un contexte initial de l'autre.
Une citation ne compte que si elle est une phrase complète de la fiche
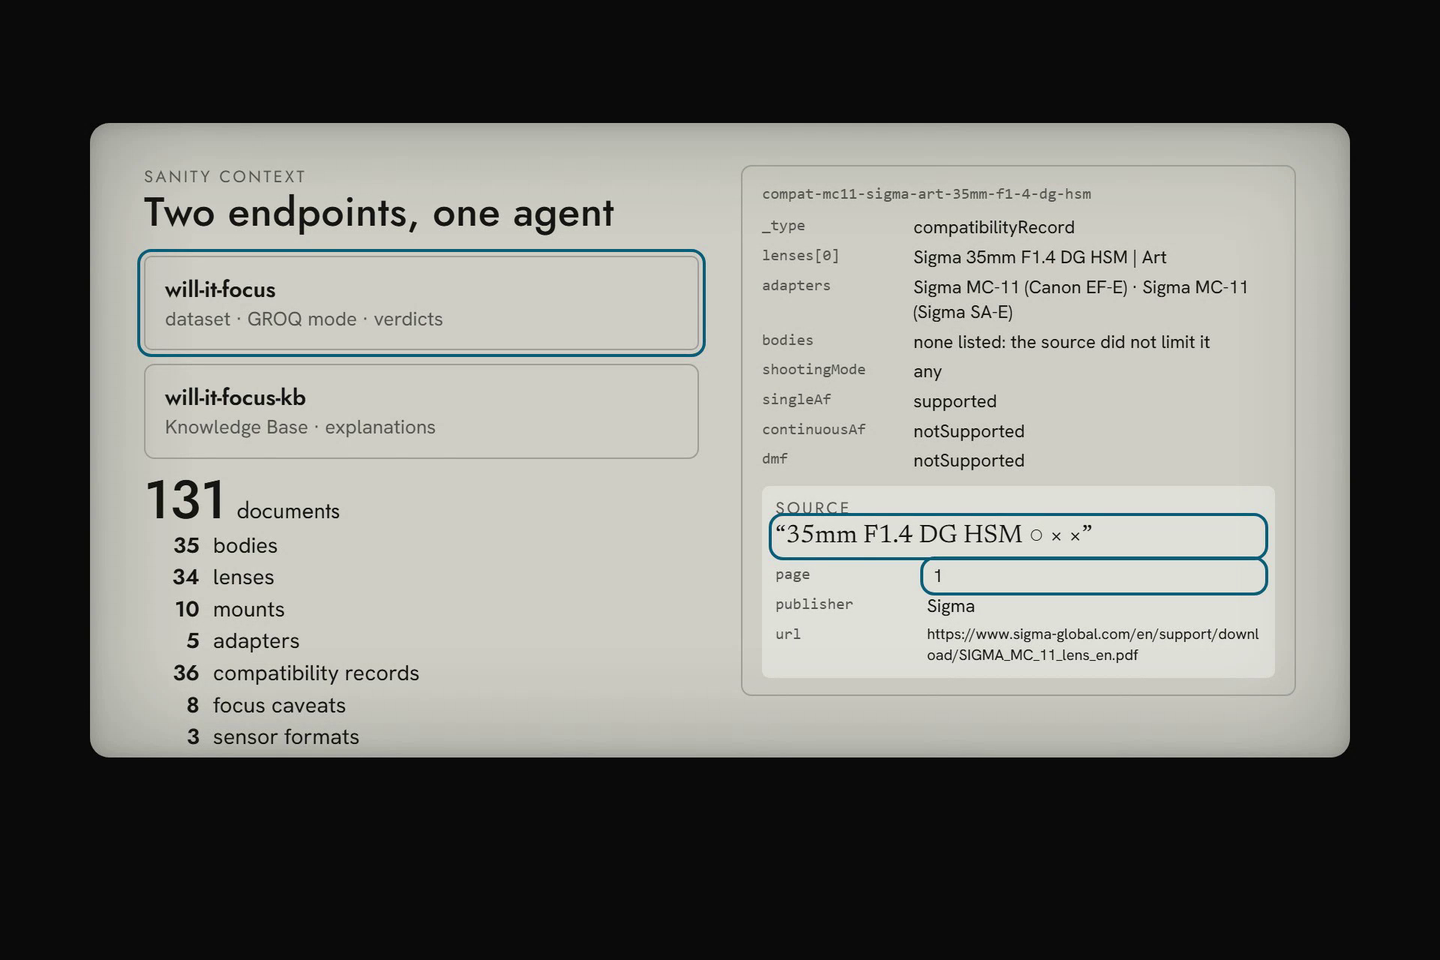
La règle sur laquelle toute l'application repose s'exécute après que le modèle a fini, pas à l'intérieur de la consigne. Chaque citation que l'agent renvoie est recherchée, par le code, dans la fiche Sanity dont l'agent a dit qu'elle venait. Elle ne compte que si elle est une phrase complète, ou une suite de phrases complètes, de la citation stockée dans cette fiche. Une correspondance approximative ne compte pas, et une version nettoyée de la phrase ne compte pas. Quand le modèle a reformulé quelque chose, la page le dit et imprime la vraie phrase de la fiche en dessous, pour que vous voyiez à la fois ce que l'agent a écrit et ce que le fabricant a écrit. Chaque état de mise au point dans la réponse est aussi comparé aux champs des fiches citées par l'agent, et tout état qu'aucune fiche citée n'appuie est étiqueté. La raison pour laquelle ce doit être du code plutôt qu'une consigne, ce sont les 13 citations inventées : un modèle à qui on a dit de citer exactement produira quand même quelque chose qui se lit exactement comme une citation, et aucune formulation de consigne ne transforme cela en citation vérifiée.
Trois passages, et les verdicts bougent à peine
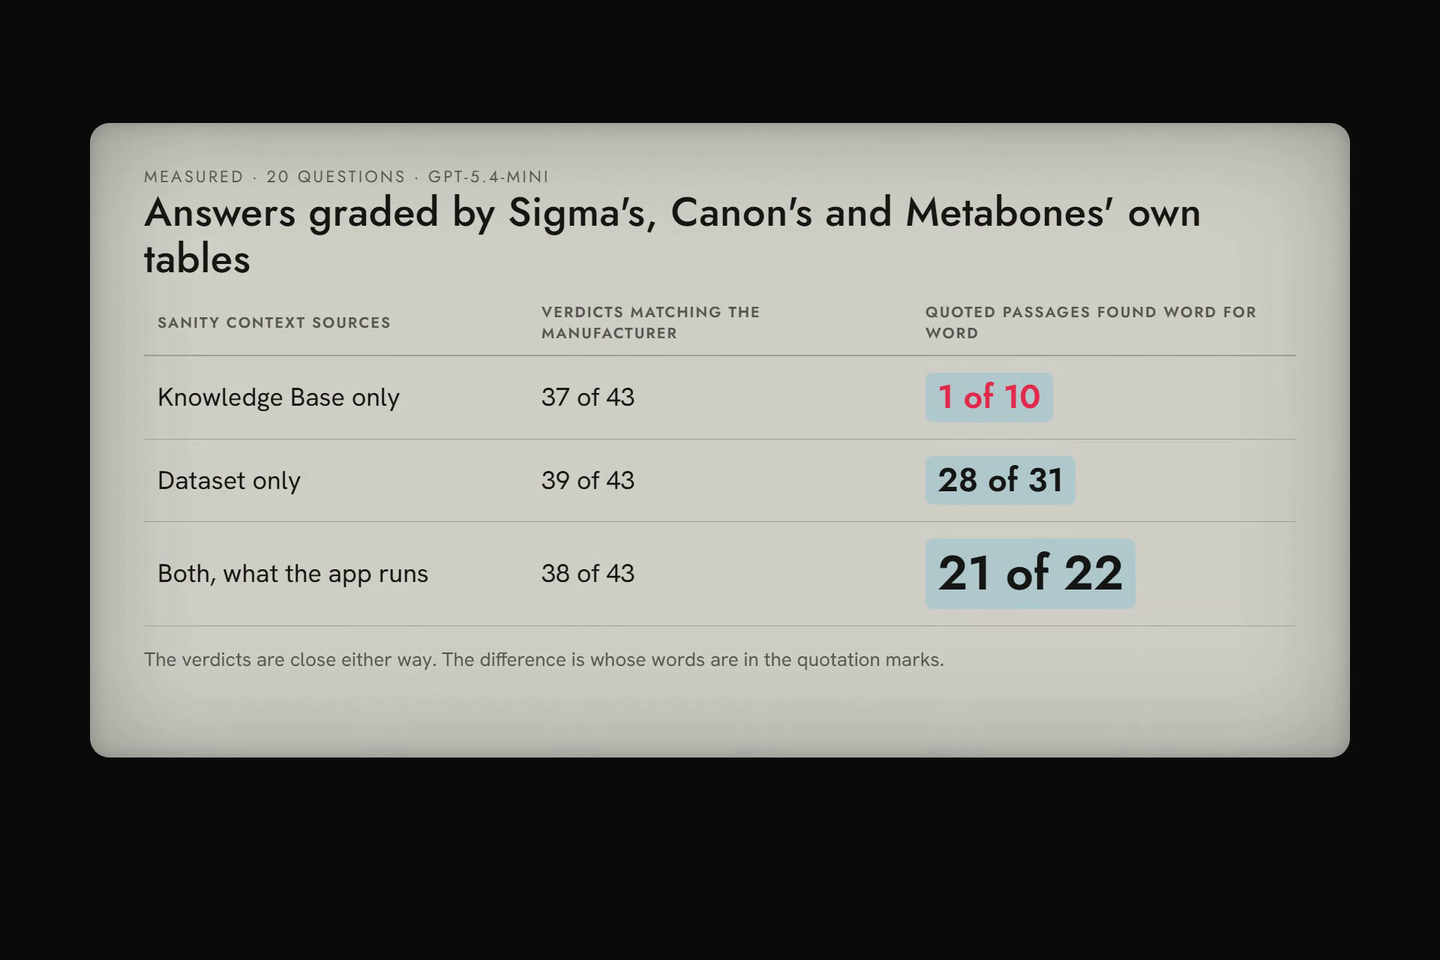
Vingt questions, choisies parce que leurs réponses se trouvent dans les tableaux et les manuels de Sigma, de Canon et de Metabones, passées de trois façons sur le même modèle. La base de connaissances seule obtient 37 verdicts justes sur 43 et 1 passage cité textuellement sur 10. Le jeu de données typé seul obtient 39 sur 43 et 28 sur 31. Les deux ensemble, ce que l'application déployée fait tourner, obtiennent 38 sur 43 et 21 sur 22. Lisez les deux colonnes l'une contre l'autre, parce que le point intéressant est que les verdicts bougent à peine. Si tout ce que vous voulez est un oui ou un non, la base de connaissances est presque aussi bonne. Toute la différence entre les lignes, c'est de savoir si les mots entre guillemets appartiennent au fabricant. Je n'avais pas prévu cela comme une ablation et c'est devenu la chose la plus utile du dépôt : elle dit ce que les fiches typées apportent vraiment, dans la seule unité qui compte, au lieu d'affirmer qu'elles étaient nécessaires. L'évaluation a aussi trouvé deux de mes propres erreurs. J'avais d'abord rangé la colonne DMF de Sigma dans une note en texte libre, que l'agent ne pouvait pas interroger, alors il répondait non couvert à chaque question sur le DMF jusqu'à ce que ce devienne un champ typé. Et le plus petit modèle manquait des fiches parce que « Sony a7 IV » ne correspondait pas à l'alias « a7 IV », puis inventait un identifiant pour combler le trou. Les boîtiers et les objectifs portent maintenant les noms que les gens tapent vraiment, et il est dit à l'agent de ne jamais construire un identifiant.
Le schéma devait avoir le droit de ne rien dire
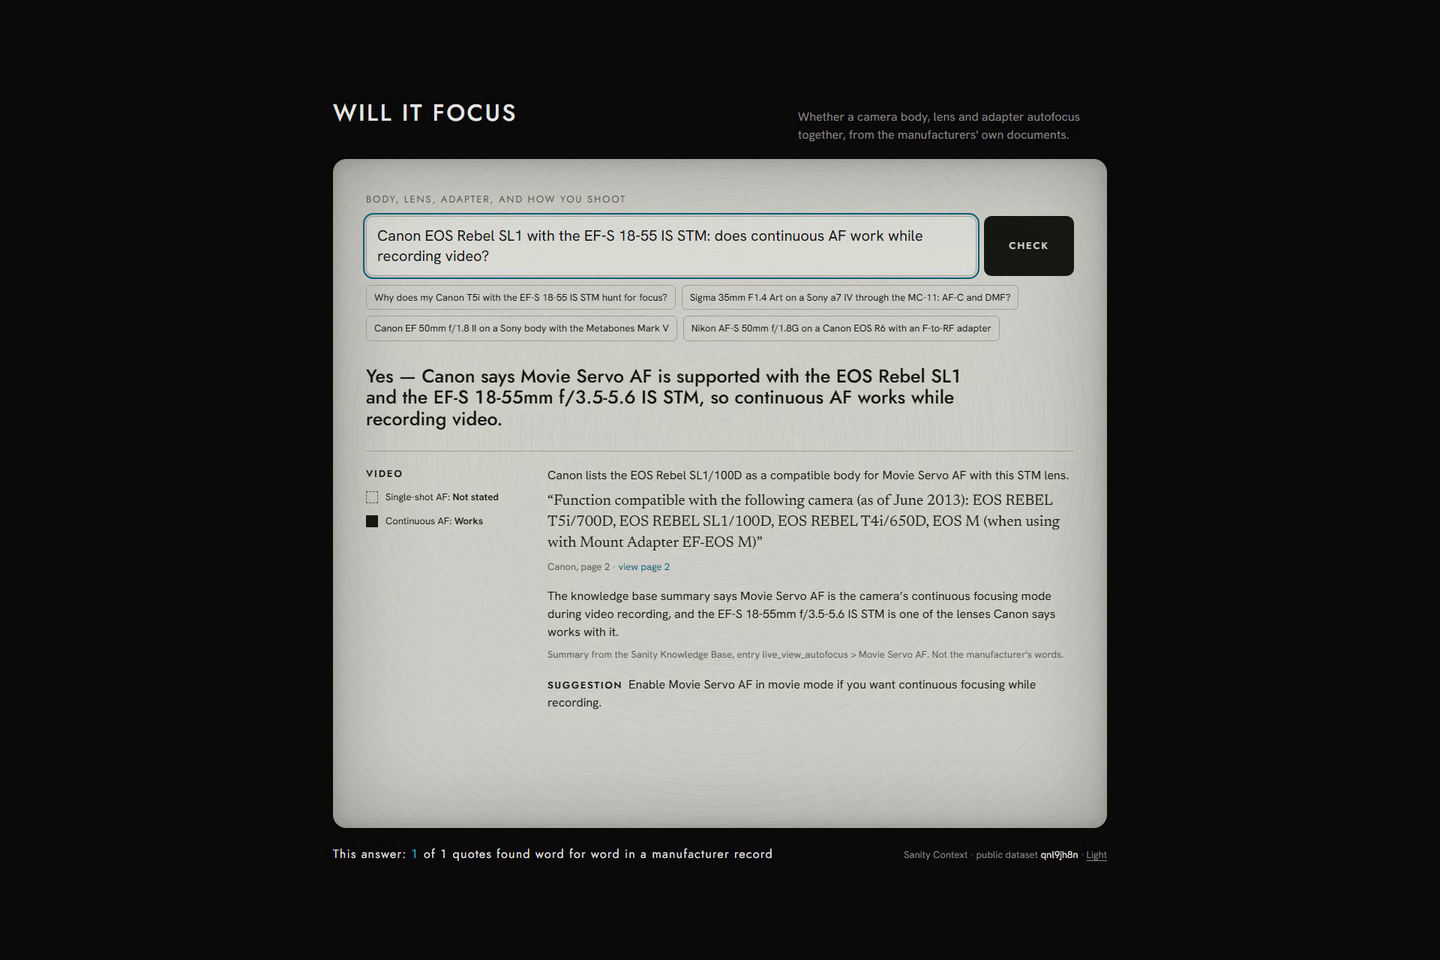
Trois décisions de schéma ont fait l'essentiel du travail. La mise au point automatique est séparée en photo au viseur, visée par l'écran et vidéo, parce que le même boîtier fait le point avec du matériel véritablement différent dans chacun de ces cas et qu'un champ unique aurait forcé une réponse à en représenter trois. Une fiche de compatibilité n'est jamais plus large que sa source : la note de Canon sur le 18-55 STM nomme quatre boîtiers, donc cette fiche renvoie à exactement quatre boîtiers, et quand le tableau de Sigma ne nomme aucun boîtier, la fiche n'en renvoie aucun, ce que l'agent lit comme non limité à des boîtiers particuliers. Et chaque champ qu'une source pourrait simplement ne pas aborder peut répondre qu'aucune source ne l'énonce. Ce dernier point compte plus qu'il n'y paraît. Un schéma qui n'offre que oui ou non force le modèle à deviner, et une supposition dans une réponse de compatibilité est indistinguable d'un fait jusqu'à ce que quelqu'un achète l'adaptateur.
La meilleure réponse qu'il donne est l'absence de réponse
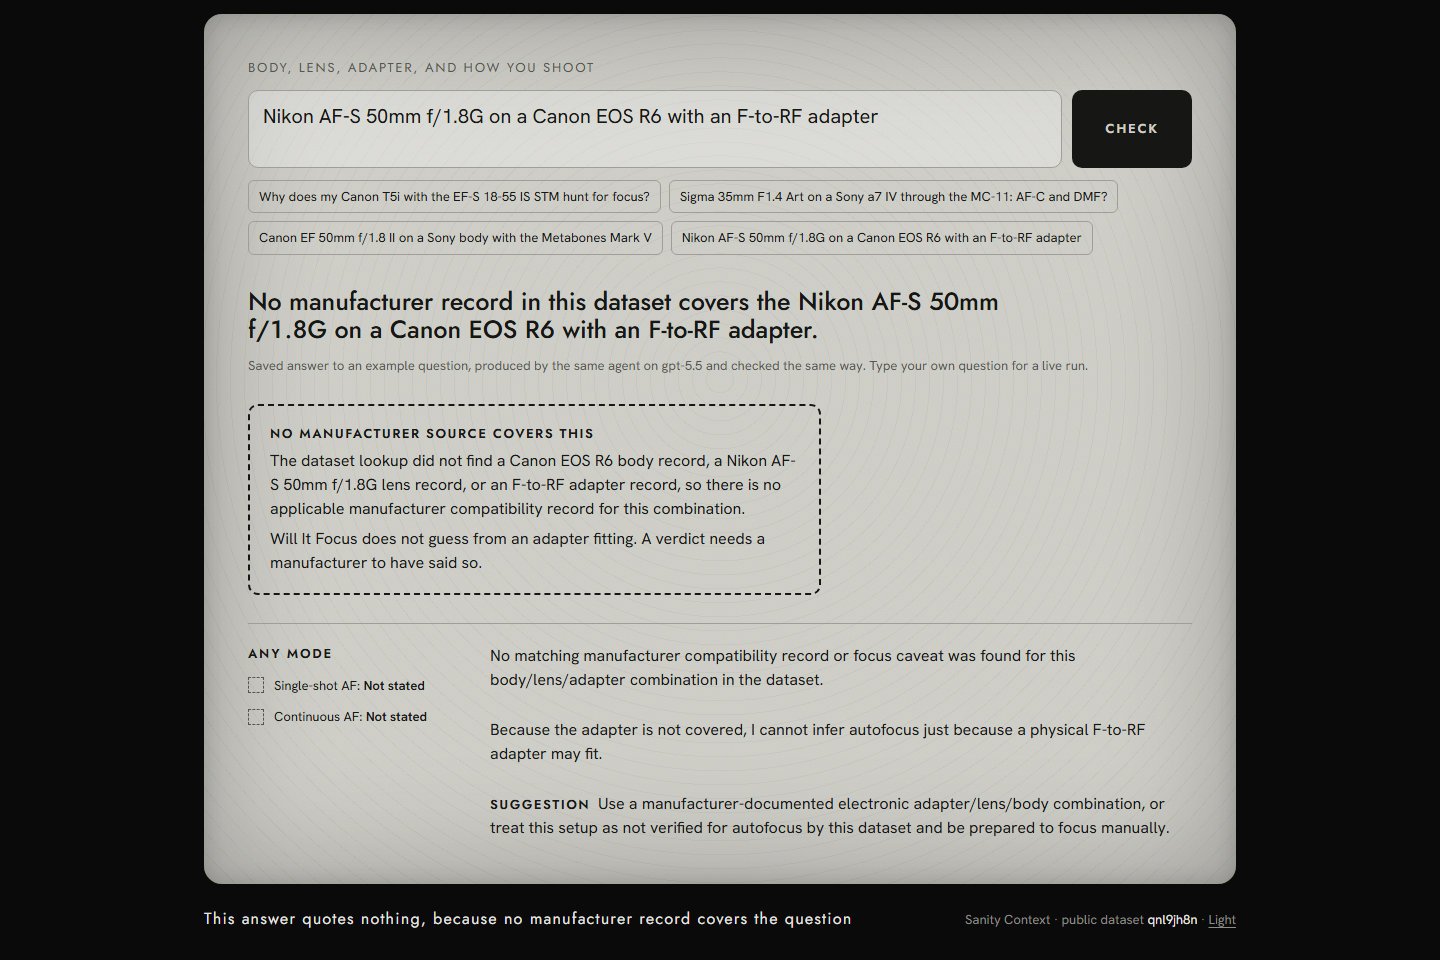
Mettez un objectif Nikon F sur un boîtier Canon RF par un adaptateur tiers et l'application ne renvoie aucun verdict. Personne n'a publié de réponse pour cette combinaison, donc il n'y a rien à citer et rien à défendre. C'est le cas que je voulais le plus réussir, parce que la mauvaise réponse plausible est facile : un adaptateur qui se monte physiquement vous laissera prendre une photo, donc un modèle sans fiche devant lui raisonnera volontiers jusqu'à conclure que la mise au point fonctionne probablement. Cela ne suit pas, et le refus est la fonctionnalité. Le même instinct explique pourquoi la porte signale une citation non vérifiée au lieu de la supprimer. Une citation qui disparaît discrètement ressemble à une réponse propre ; une citation affichée comme non vérifiée à côté de la vraie phrase du fabricant vous dit exactement jusqu'où lui faire confiance.
Deux scripts qui font échouer la compilation
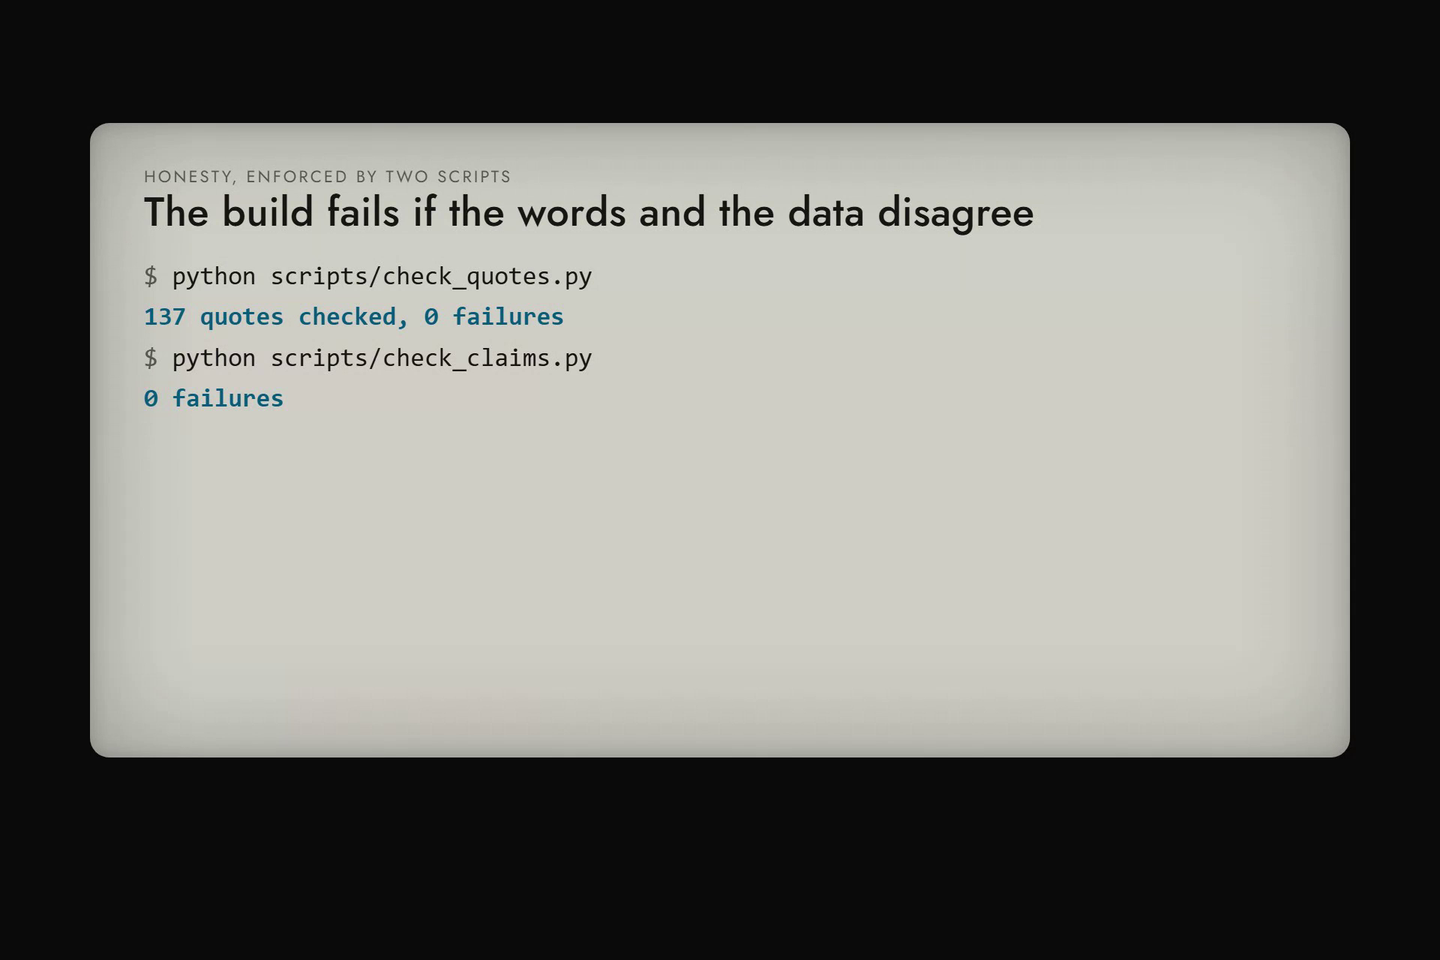
La citation de chaque fiche doit survivre à une vérification contre le document dont elle prétend venir. Un script télécharge les PDF des fabricants, en extrait le texte, et échoue si une citation n'est pas à la page indiquée de son PDF indiqué, ou absente du texte de page recueilli pour les sources web. Il passe sur 137 citations avec zéro échec, et c'est la raison pour laquelle je peux dire que les fiches sont textuelles au lieu de l'espérer. Un second script lit les chiffres du README et du billet et échoue si l'un d'eux contredit les données. Je rebâtis celui-là chaque fois parce qu'un chiffre écrit un mardi et un pipeline relancé un mercredi, c'est exactement ainsi qu'un billet finit par mentir sur ses propres résultats, et je préfère que la compilation me le dise plutôt qu'un lecteur.
Ce qui n'est pas revendiqué
La porte prouve qu'une citation appartient à la fiche citée par l'agent. Elle ne prouve pas que l'agent a cité la bonne fiche pour votre combinaison exacte, et c'est la limite honnête de la conception : je peux vérifier les mots, pas la pertinence. Le jeu de données est petit, couvrant l'époque du T5i chez Canon, le MC-11 de Sigma, le EF-E Mark V de Metabones et les adaptateurs EF-EOS R et EF-EOS M de Canon, donc beaucoup de combinaisons réelles ne renvoient aucun verdict. Cinq distances de tirage viennent de Wikipédia plutôt que d'un fabricant, parce qu'aucune page de fabricant ne les énonce, et ces fiches le disent ouvertement au lieu d'emprunter l'autorité de celles qui le font. Les quatre questions d'exemple sont des réponses enregistrées plutôt que des passages en direct, revalidées contre les fiches courantes à chaque affichage, et la page dit laquelle est laquelle. Et le chiffre principal est 21 sur 22 sur vingt questions, ce qui est un petit échantillon par choix : je n'ai utilisé que des questions dont je pouvais montrer la réponse dans un document, parce qu'un plus grand échantillon corrigé par moi-même aurait valu moins qu'un petit corrigé par Canon.
Will It Focus: whether a camera body, lens and adapter will autofocus together, with every quote checked by code against the manufacturer's own document
Voir le projet