Nightshift lit 2 000 brevets en 4 minutes pour 34 $ et trouve la référence que l'examinateur a manquée
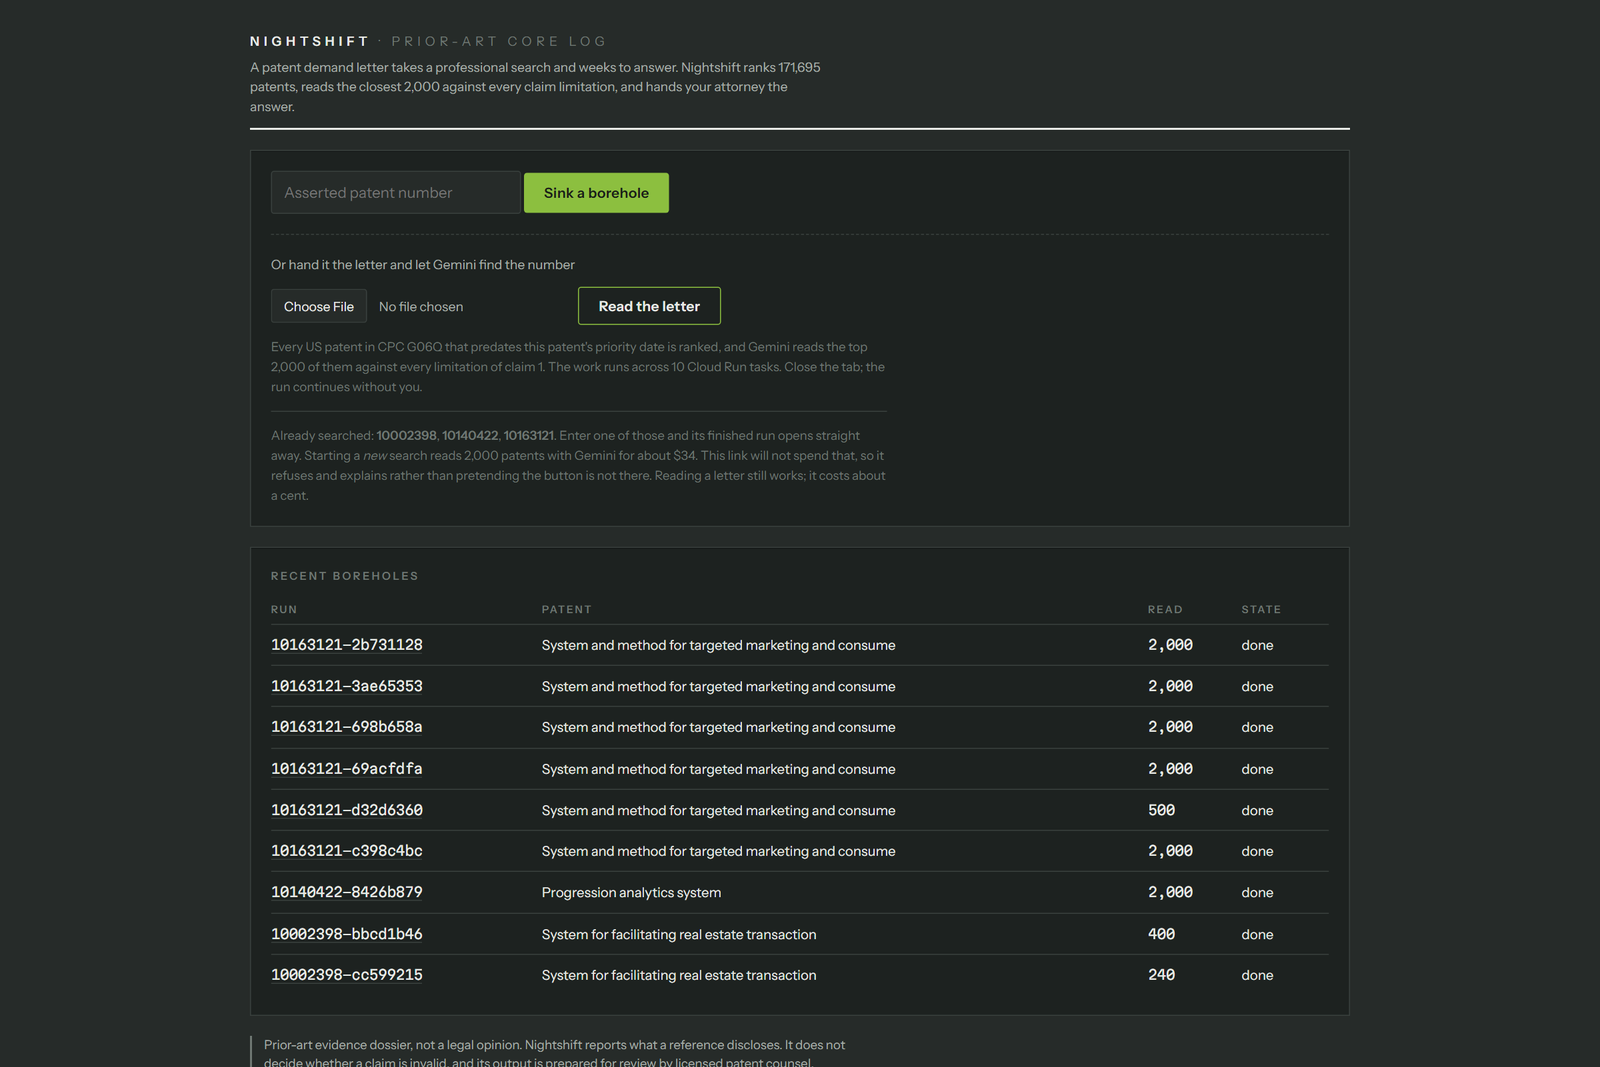
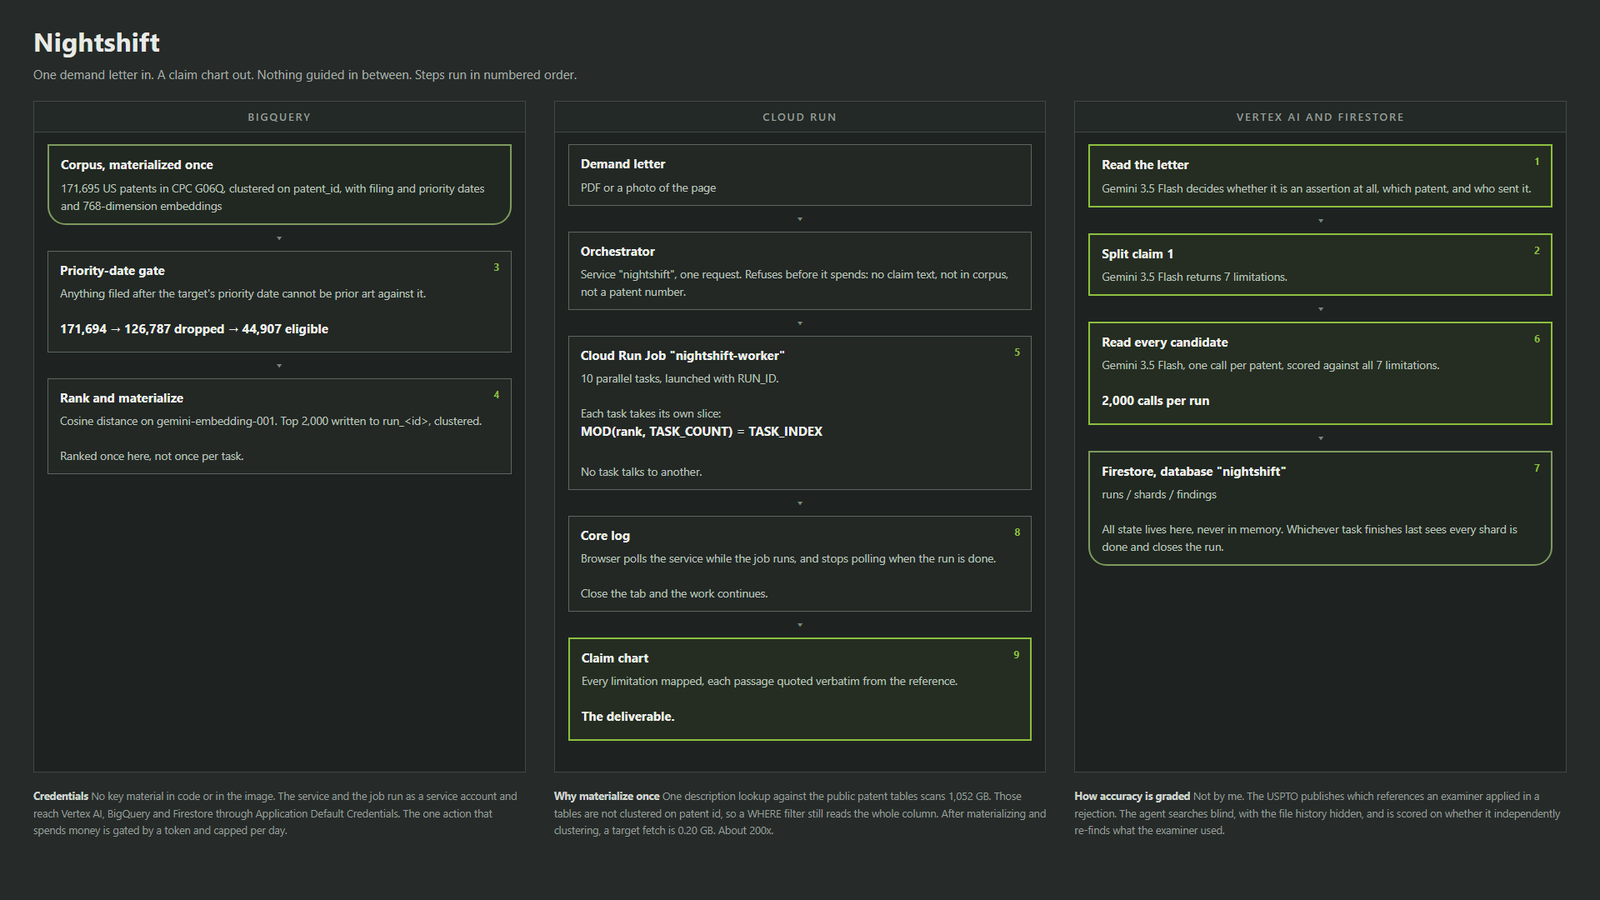
Chaque outil d'antériorité existant est un système de récupération : classer un corpus, montrer à un humain le top-quelques-dizaines. Ça a un plafond mesurable : avec le meilleur embedding disponible, un top-50 rate encore 59,7 % des références qu'un examinateur USPTO a réellement appliquées. Nightshift est un système de jugement : une passe vectorielle réduit 171 695 brevets, puis Gemini en lit deux mille, pas cinquante, décidant pour chacun s'il divulgue chaque limitation. En aveugle contre les vraies citations d'actions d'office USPTO : 97,5 % de rappel des références d'anticipation appliquées par l'examinateur (n=40), 92,5 % sur l'obviousness (n=40), 18,8 % sur un ensemble de contrôle jamais cité. Sur la démo, 4 minutes sur 10 tâches Cloud Run, 34,57 $, il a fait remonter indépendamment la référence X-cite de l'examinateur à profondeur 218, plus une référence de 1998 que l'examinateur a manquée qui enseigne six des sept limitations en propre.
Pourquoi la récupération seule a un plafond
Chaque outil d'antériorité existant est un système de récupération : classer un corpus, montrer à un humain le top-quelques-dizaines. En classant ce corpus avec `gemini-embedding-001`, le meilleur embedding disponible, un top-50 rate encore 59,7 % des références qu'un examinateur USPTO a réellement appliquées pour anticiper une revendication. Un meilleur classement ne le corrige pas. Lire plus loin dans la liste, si. Profondeur 20 trouve 26,6 % des références d'anticipation, profondeur 50 trouve 40,3 %, profondeur 500 trouve 71,0 %, profondeur 2 000 trouve 83,9 %. Le préfiltre n'est pas appelé à avoir raison, seulement à ne pas perdre la réponse.
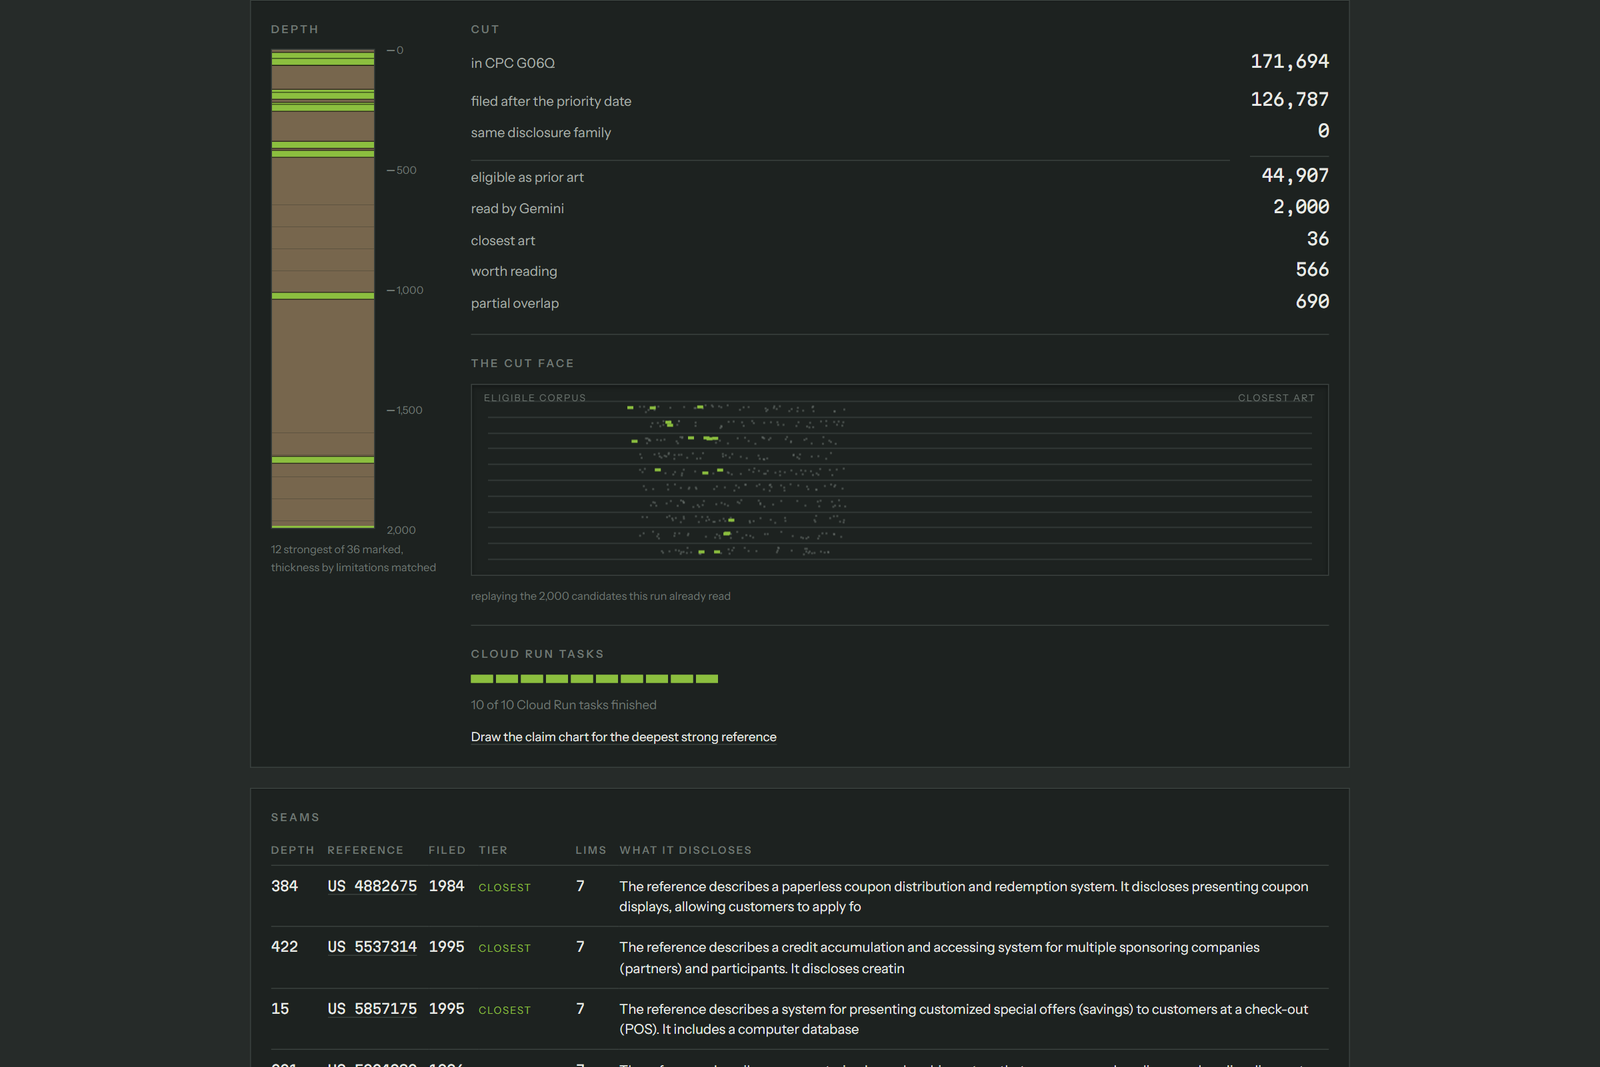
Noté par des examinateurs USPTO, pas par moi
En aveugle : le modèle ne voit jamais le numéro, le titre, le titulaire ou les dates de la référence, donc il ne peut s'appuyer sur rien qu'il aurait mémorisé. Sur 40 références qu'un examinateur USPTO a appliquées comme anticipation §102, le filtreur en signale 97,5 %. Sur 40 références appliquées comme obviousness §103, 92,5 %. Sur un ensemble de contrôle de 80 références que l'examinateur n'a jamais citées, tirées du même corpus et passant la même barrière de date de priorité, 18,8 %. Le contrôle est ce qui donne du sens aux deux autres : le rappel seul se truque trivialement en signalant tout, donc le même filtreur passe sur des références que l'examinateur n'a pas citées. De bout en bout (préfiltre × filtreur) à 2 000 candidats : 81,8 % sur les X-cites, 62,8 % sur les Y-cites.
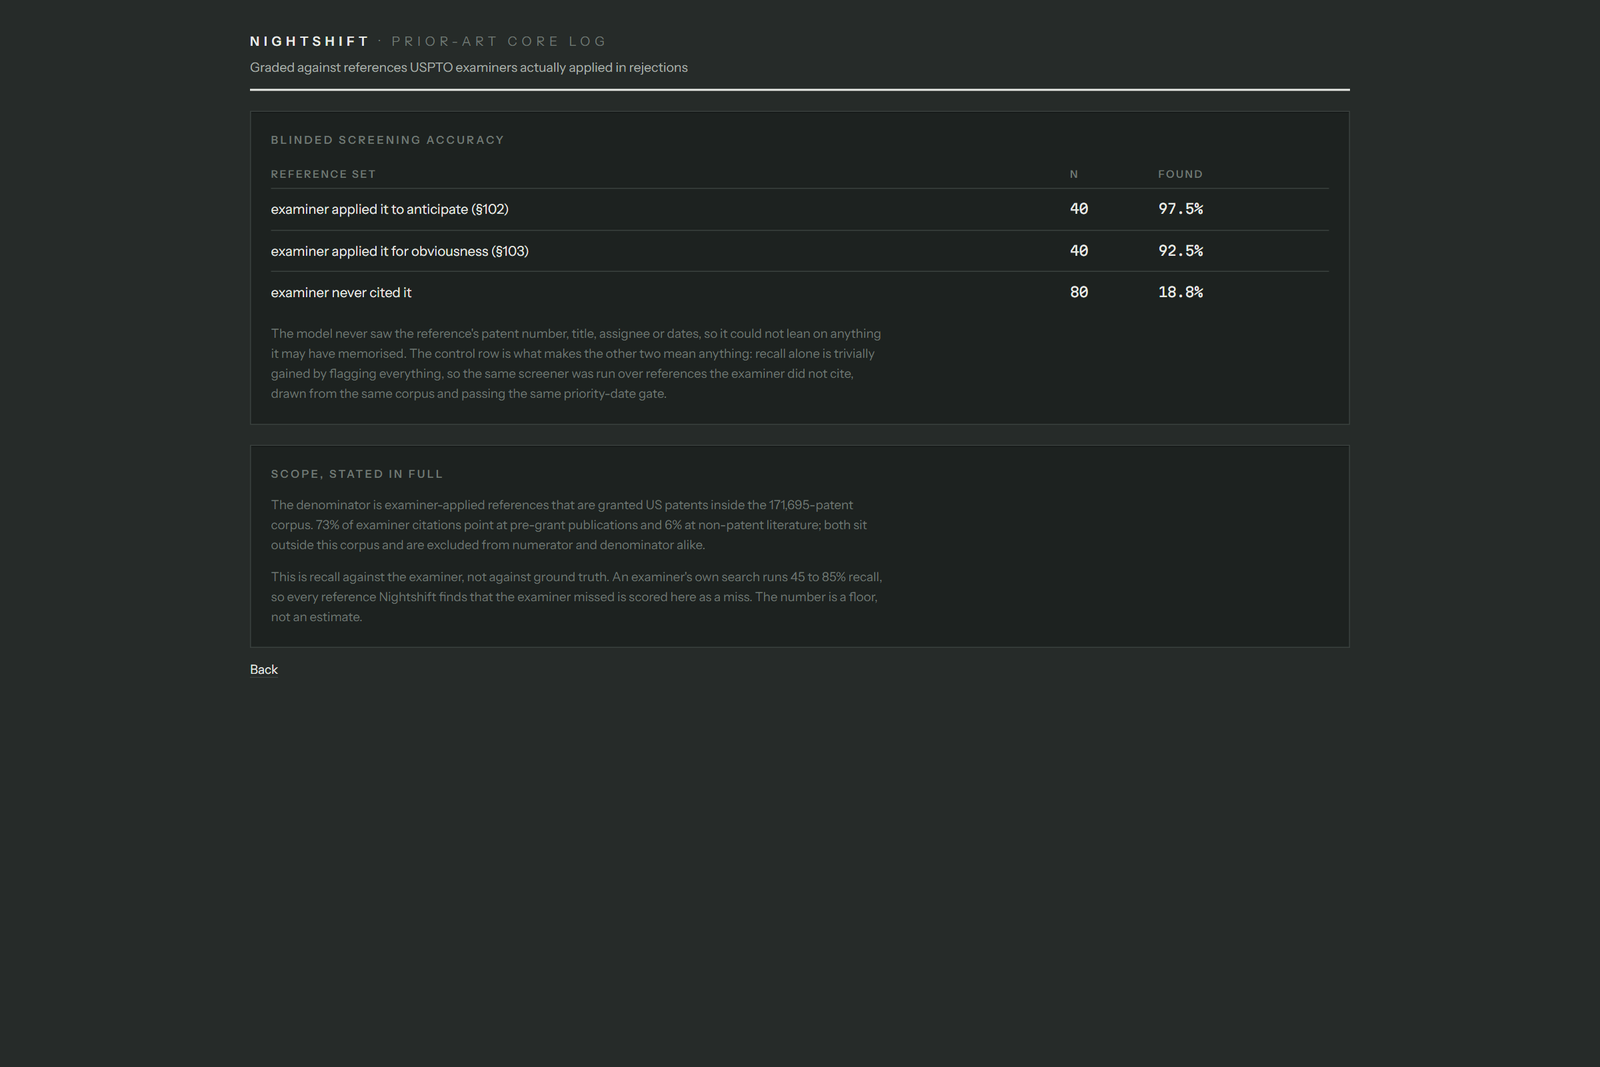
L'exécution de démo, de bout en bout
Exécution `10163121-c398c4bc`, une vraie exécution Cloud Run. Cible : US 10 163 121 (marketing ciblé et gestion des ressources consommateur), poursuivie contre US 7 606 730 (carte de valeur stockée multi-marchands), que l'examinateur USPTO a appliquée comme rejet catégorie-X anticipation. En aveugle, sans jamais voir l'historique du dossier, Nightshift a fait remonter indépendamment cette même référence à profondeur 218, au-delà de toute liste courte qu'on montre à un humain. Les deux brevets ne partagent presque aucun vocabulaire : l'un s'appelle marketing ciblé, l'autre carte de valeur stockée, et les deux décrivent l'accumulation de valeur de fidélité et son remboursement à un point de vente marchand. C'est pourquoi la recherche par mots-clés le rate et pourquoi l'étape de jugement doit lire plutôt que faire correspondre. Temps de mur ~4 minutes sur 10 tâches Cloud Run. Coût 34,57 $.
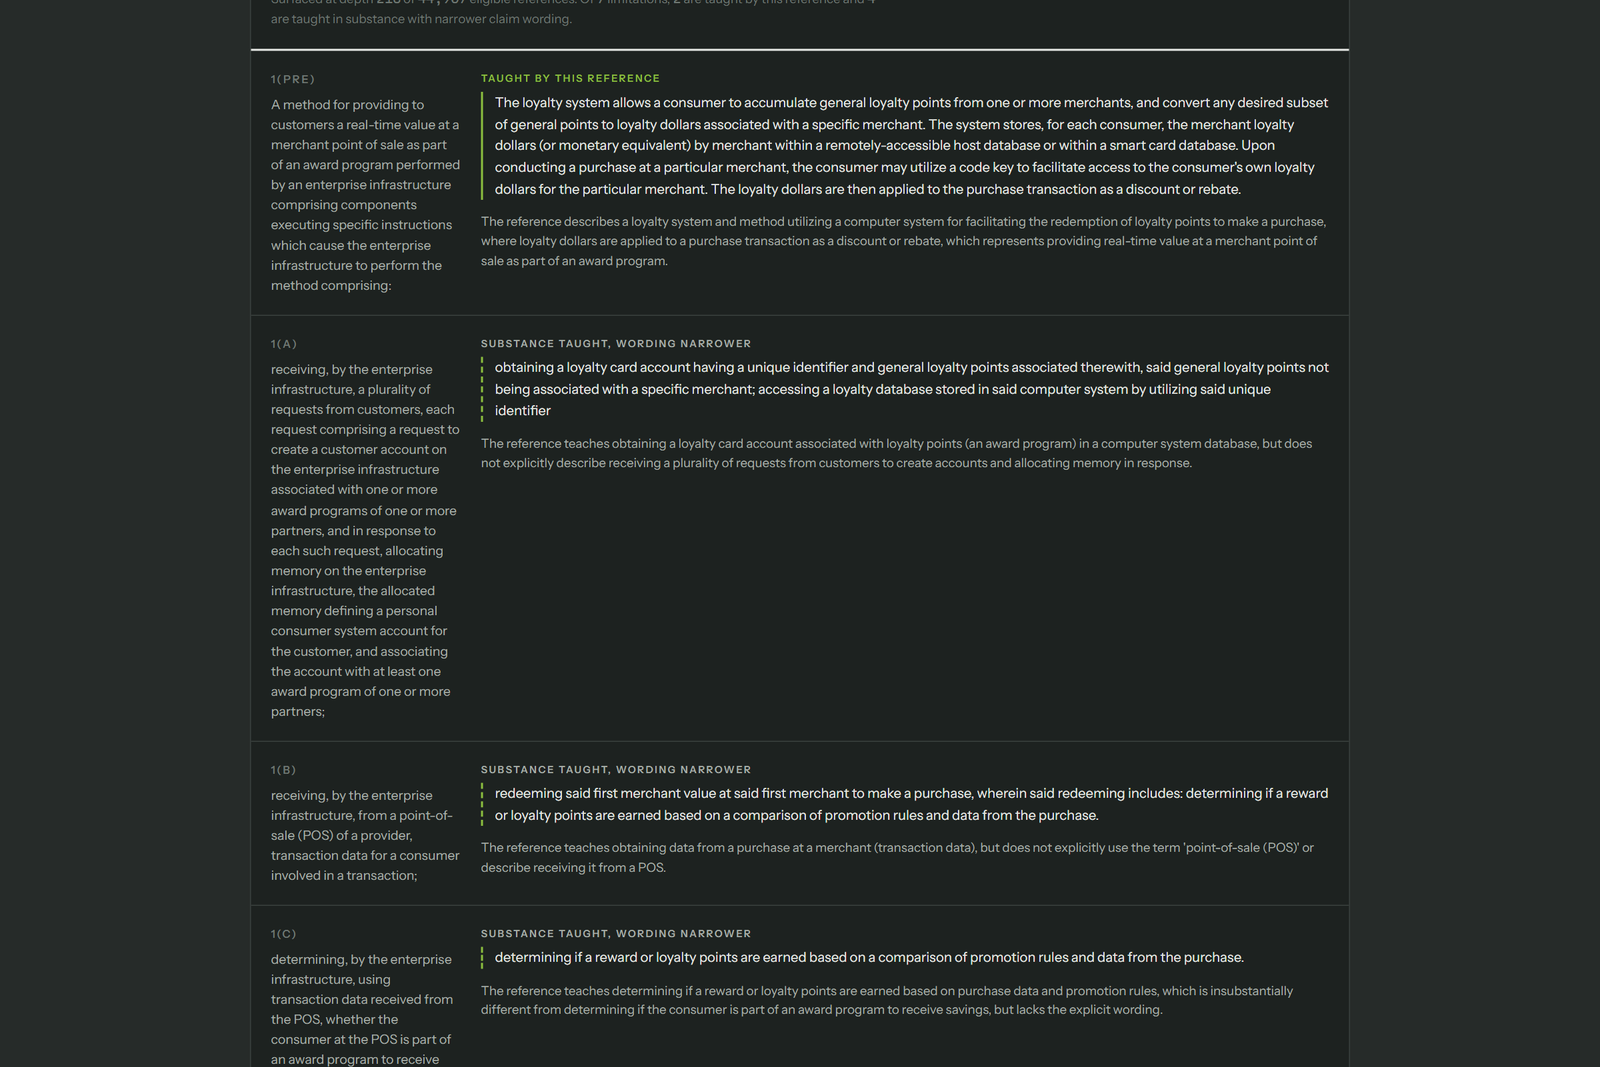
Le résultat qui compte plus
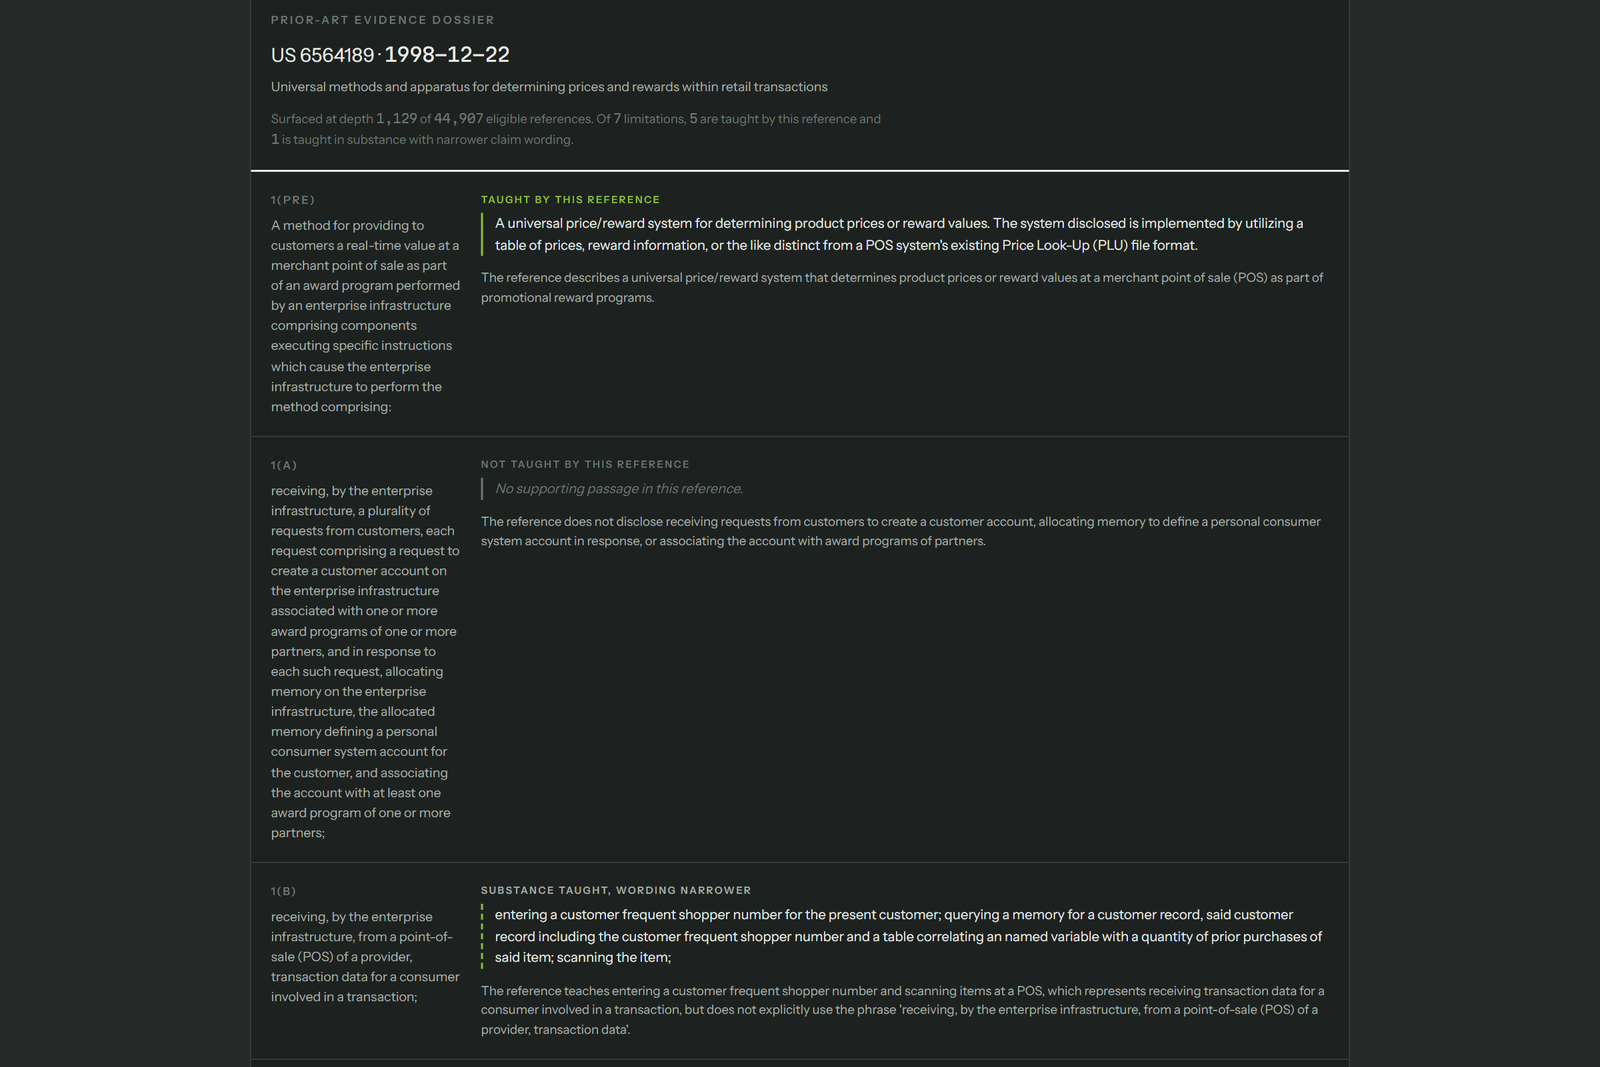
Retrouver ce qu'un examinateur a déjà trouvé prouve que la méthode fonctionne. Trouver ce que l'examinateur a manqué est le produit, et cette exécution l'a fait. US 6 564 189, déposé le 22 décembre 1998, presque huit ans avant la date de priorité de ce brevet, n'apparaît nulle part dans les citations de l'examinateur. Il enseigne six des sept limitations en propre là où la référence de l'examinateur en enseigne deux. Selon la propre métrique de Nightshift, ça compte ici comme un manqué, parce que l'évaluation est mesurée contre l'examinateur et pas contre une vérité terrain. C'est la lecture honnête de chaque chiffre de rappel dans ce billet : ce sont des planchers de performance, pas des estimations. Quelle référence fait la meilleure argumentation d'invalidité dépend de la construction de la revendication et de l'argument, et ce sont des questions pour un conseil.
Architecture, et pourquoi le coût l'a dirigée
Interroger la table publique des brevets par requête n'est pas viable : une seule recherche de description scanne 1 052 Go, et une récupération de cible jointe aux revendications scanne 40 Go, parce que ces tables ne sont ni partitionnées ni regroupées par identifiant de brevet. Donc le corpus est matérialisé une fois et regroupé. Une récupération de cible est passée de 40,16 Go à 0,20 Go, un facteur d'environ 200. Gemini tourne sur Vertex AI (pas l'endpoint AI Studio) donc aucune clé API n'est requise et les plafonds du free-tier AI Studio qui rendent le travail sur des milliers de candidats inutilisable sont évités ; le compte de service s'authentifie. Cloud Run Jobs répartit le travail sur 10 tâches en utilisant l'index de tâche Cloud Run pour distribuer les candidats via `MOD(rank, TASK_COUNT) = TASK_INDEX`.
Nightshift: agentic prior-art search that reads 2,000 patents in 4 minutes for $34
Voir le projet
Je viens de publier mon premier cours Udemy : la construction de catalogue ServiceNow que j'ai faite vingt fois, plus le Now Assist Skill Kit de bout en bout
Deux ans dans l'équipe ServiceNow au Cirque du Soleil, plus une période sur du travail client à N2, m'ont appris quelles parties du stack catalogue + Flow Designer + Now Assist vous utilisez vraiment et lesquelles la doc vous fait croire importantes mais ne le sont pas. Le cours est ce filtre, enregistré à partir de zéro sur une instance neuve, terminé par un flux de publication Now Assist Skill Kit qui n'est pas encore dans la doc. Code promo de lancement à l'intérieur.
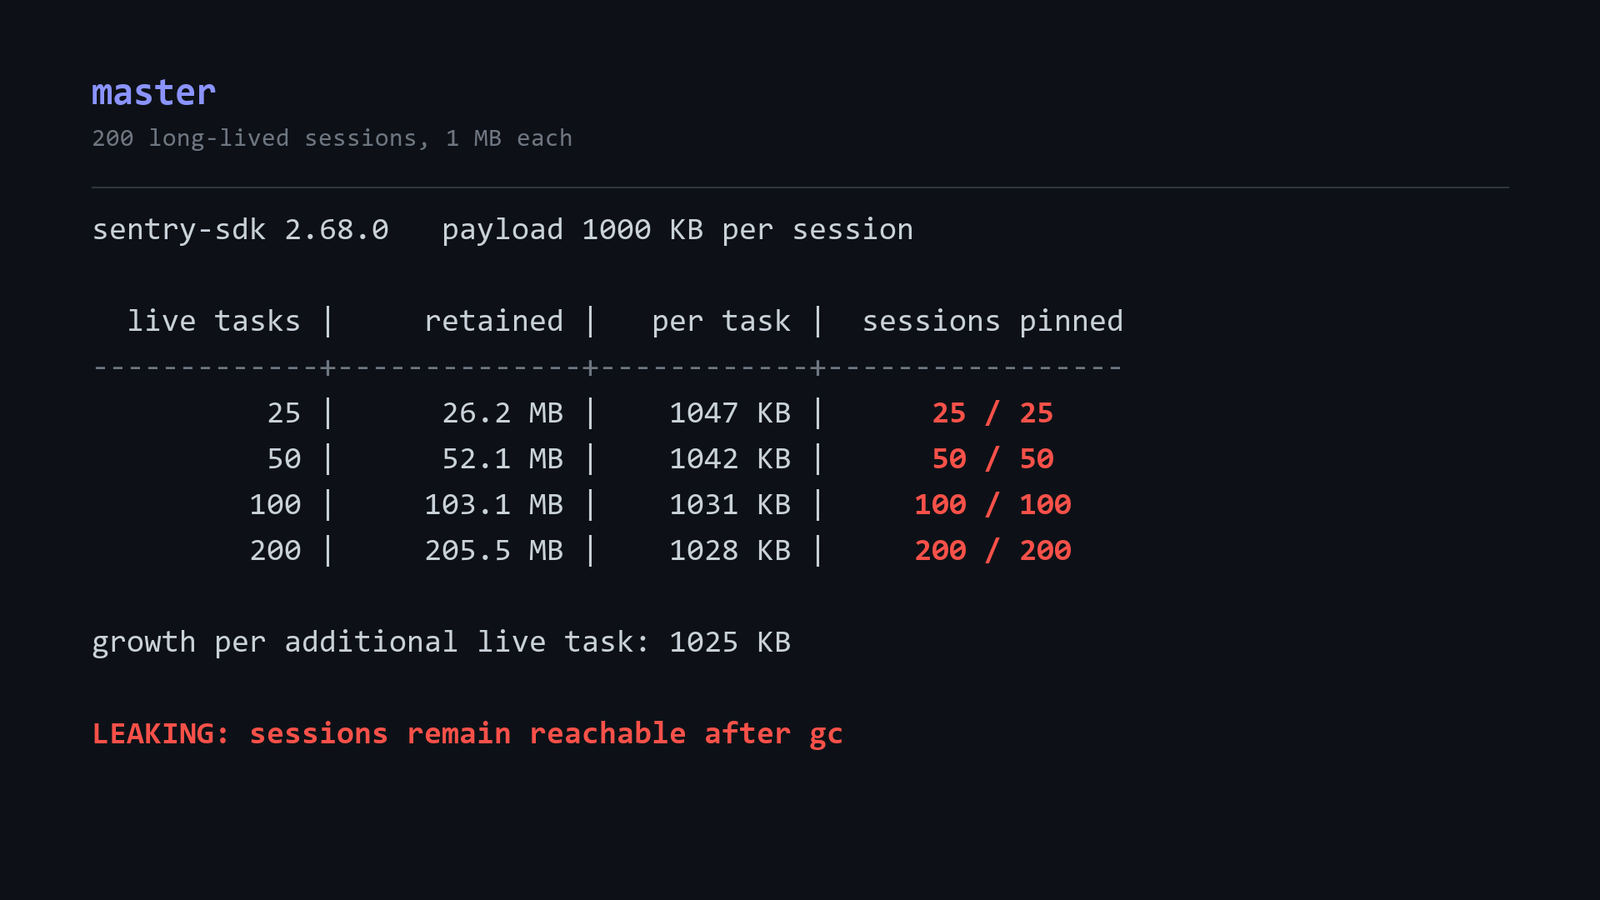
Python ne peut pas prendre une weakref sur un ValueError. La déduplication de Sentry l'a appris à ses dépens : 1024 Ko par tâche asyncio vivante.
La DedupeIntegration de sentry-python empêche qu'une même erreur soit rapportée deux fois en se souvenant de la dernière exception. Se souvenir d'une exception est exactement ce qu'il ne faut pas faire : une exception détient sa traceback, une traceback détient ses frames, un frame détient chaque local. Le SDK le savait et stockait un weakref.ref(exc). Les trois lignes sous le commentaire `# we can only weakref non builtin types` font la seule chose que la weakref existait pour empêcher : un `except TypeError:` attrape le refus de Python de prendre une weakref sur un builtin et retient silencieusement l'exception. Sous asyncio, chaque tâche garde sa propre copie dans un ContextVar, donc 200 sessions de longue durée épinglent 205 Mo, toutes atteignables après gc.collect(). Deux tentatives avant le correctif, une empreinte par valeur qui échoue aux propres tests du SDK, une empreinte basée sur id qui écrase 2000 erreurs distinctes en 2 clés, puis l'approche du jeton d'identité qui garde le comportement inchangé et fait tomber la rétention à 0,5 Mo.