Laisser Gemini écrire le SQL sur BigQuery pour que les fans n'aient pas à le faire
Une couverture baseball personnalisée qui personnalise vraiment : suivez vos joueurs, choisissez votre horaire, et une couche SQL traduite par LLM laisse l'IA générer des stats et des visualisations à partir de données MLB fraîches, sans changement de code.
La couverture sportive est bimodale : encyclopédique pour les statisticiens, en passant pour les occasionnels. Il n'y a presque rien pour un fan qui veut de la profondeur sur ses trois joueurs favoris et un coup d'œil sur tout le reste. Le hackathon Google MLB a été l'occasion de bâtir ça.
Pourquoi je l'ai bâti
Je voulais apprendre la stack données et IA de Google sur le terrain, et le défi 2 du hackathon (contenu personnalisé pour les fans) m'a donné un problème clair à viser. La promesse que j'ai verrouillée tôt : un fan choisit quelques joueurs et équipes, et le système lui écrit un briefing quotidien dans sa langue, avec des graphiques qu'il peut générer en posant une question en langage naturel.
Ce que ça fait
L'utilisateur crée un compte, suit des joueurs et des équipes, puis commence à recevoir des articles générés par IA par courriel à la fréquence de son choix. Les articles sont écrits dans sa langue préférée (anglais, japonais ou espagnol), peuvent être sauvegardés depuis n'importe quel client courriel, et il peut se désabonner à tout moment.
Fonctionnalités distinctives
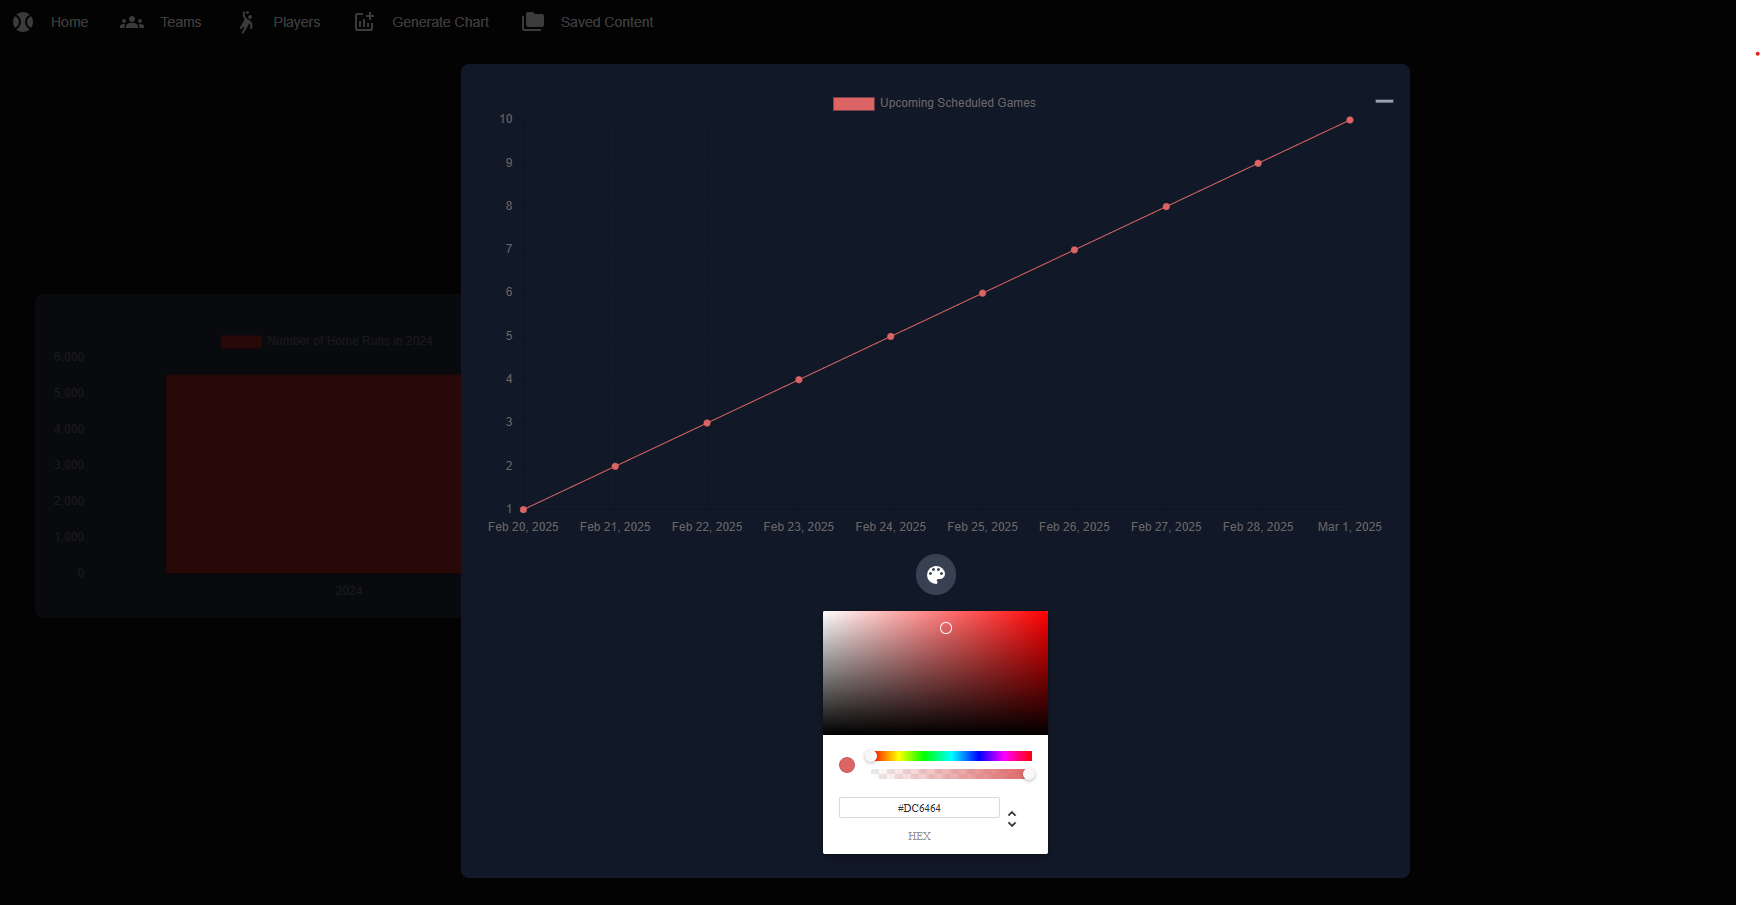
- Génération de graphiques en langage naturel : tape une question, obtiens un graphique Chart.js avec titre, étiquettes et couleurs modifiables.
- Contenu connexe découvert automatiquement (vidéos, articles) lié aux joueurs et équipes que tu suis.
- Une section de contenu sauvegardé qui peut résumer une vidéo, exporter un article en PDF et recolorer un graphique.
- Un tableau de bord d'accueil où les cartes sauvegardées peuvent être épinglées, plus un easter egg caché qui active des extraits de coups de circuit aléatoires des joueurs suivis.
- Contrôles de compte pour le nom, la langue préférée, la déconnexion et la suppression complète du compte.
Comment je l'ai bâti
Le frontend est en Next.js avec TypeScript, DaisyUI et Tailwind. Firebase stocke l'état utilisateur : joueurs suivis, équipes suivies, contenu aimé et langue préférée. Les fonctions Firebase exécutent les tâches planifiées de génération d'articles qui envoient les courriels quotidiens.
Langage naturel → SQL → graphique
Gemini lit la question de l'utilisateur et le schéma BigQuery, émet une requête SQL, l'exécute, puis remet le résultat à Gemini pour choisir le meilleur type de graphique. Chart.js fait le rendu final. J'ai rendu l'introspection du schéma dynamique, donc ajouter des colonnes ou des lignes à la table BigQuery MLB est reflété automatiquement sans une seule ligne de code modifiée. La même couche BigQuery sert aussi à apparier les joueurs et équipes suivis au contenu connexe (vidéos, articles).
Multilingue partout
Les chaînes statiques de l'interface viennent d'un fichier de traduction. Le contenu dynamique (résumés vidéo, contenu connexe, articles générés) est traduit par Gemini à la demande. Un bouton de traduction par contenu persiste la version traduite à travers les rafraîchissements, donc l'utilisateur ne paie jamais deux fois le même appel Gemini.
Ce qui a été difficile
Trois choses ont mangé la majorité du temps. Premièrement, faire respecter la langue préférée de l'utilisateur par la génération planifiée d'articles a demandé beaucoup d'ajustements : le prompt, le code de langue passé en argument et le chemin de sauvegarde post-génération devaient tous s'accorder. Deuxièmement, le résumé vidéo de Vertex AI avait des restrictions d'URL, en particulier sur les sources MLB.com. J'ai contourné ça en téléversant d'abord l'URL source dans un bucket Google Cloud Storage, puis en passant l'URL du bucket à Vertex AI, ce qui fonctionnait de façon constante. Troisièmement, je suis resté coincé plusieurs jours sur le déploiement Vercel, mais l'avoir réglé tôt a rendu chaque cycle CI suivant fluide.
Ce que j'ai appris
Premier vrai projet en Next.js, et première fois que j'utilisais BigQuery, les fonctions Firebase et Vertex AI ensemble. La combinaison qui m'a le plus surpris : Gemini avec BigQuery pour la récupération de données en langage naturel. La génération SQL consciente du schéma a rendu la fonction de graphique native aux données, pas plaquée par-dessus. Les fonctions Firebase pour le pipeline de courriels planifiés ont bouclé la boucle sans serveur worker séparé.
Ce qui s'en vient
- Mise en page plus responsive pour mobile et tablette.
- Données de graphique plus riches et un mécanisme de relance pour la génération SQL avec une limite de relances bornée.
- Plus de langues d'interface et plus de cibles de traduction dynamique.
- Cartes du tableau de bord redimensionnables et déplaçables.
- Génération d'images avec Imagen 3 à partir du texte d'article (le bouton est déjà en place, il reste à corriger le déclencheur de l'API).
- Plus d'ingénierie de prompt sur le générateur SQL pour réduire les requêtes mal formées.
FHIR + CDS Hooks + Gemini : un score de risque qu'un clinicien lira vraiment
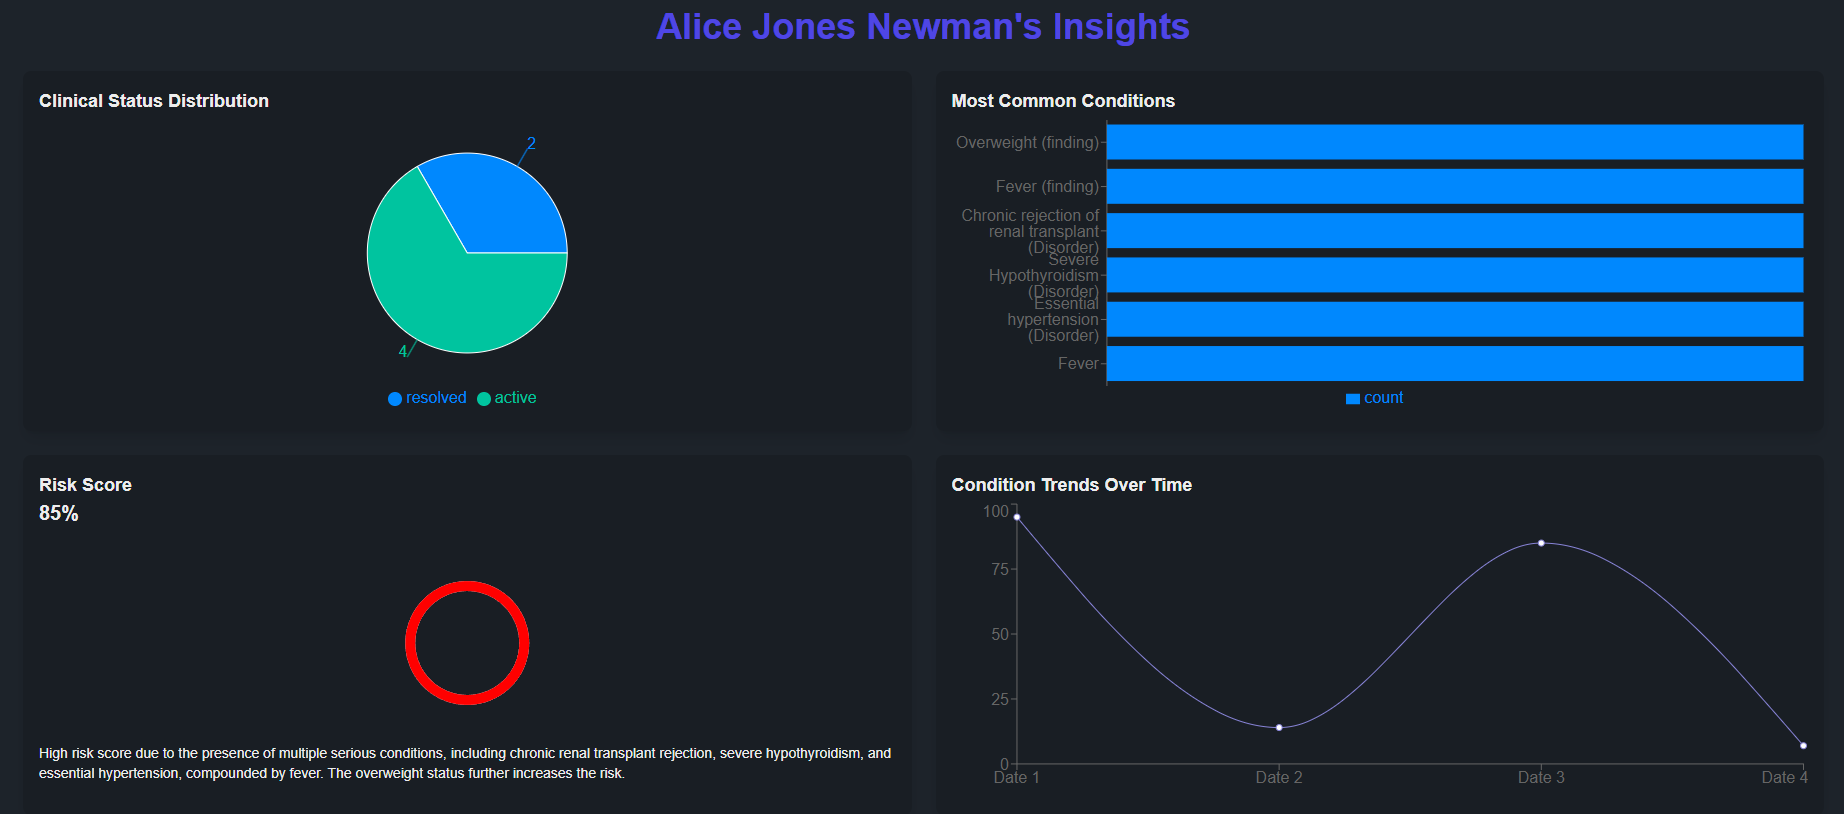
Les scores de risque meurent quand ils sont des boîtes noires. L'intégration MeldRx via FHIR/CDS Hooks tire les données patient ; Gemini Flash renvoie du JSON structuré avec explications, confiance et actions recommandées ; l'UI livre aux cliniciens un rapport PDF téléchargeable.
Ce que j'ai appris en construisant une extension autour de l'IA intégrée de Chrome
Les API Prompt, Summarizer et Translator de Chrome rendent l'IA on-device réelle. InstaQ les recoud pour que n'importe quelle page devienne une surface de Q&R, avec des sessions auxquelles on peut revenir.
À lire aussi
Un assistant caméra porte des lunettes intelligentes pendant un tournage et quitte le plateau avec la feuille de continuité déjà écrite
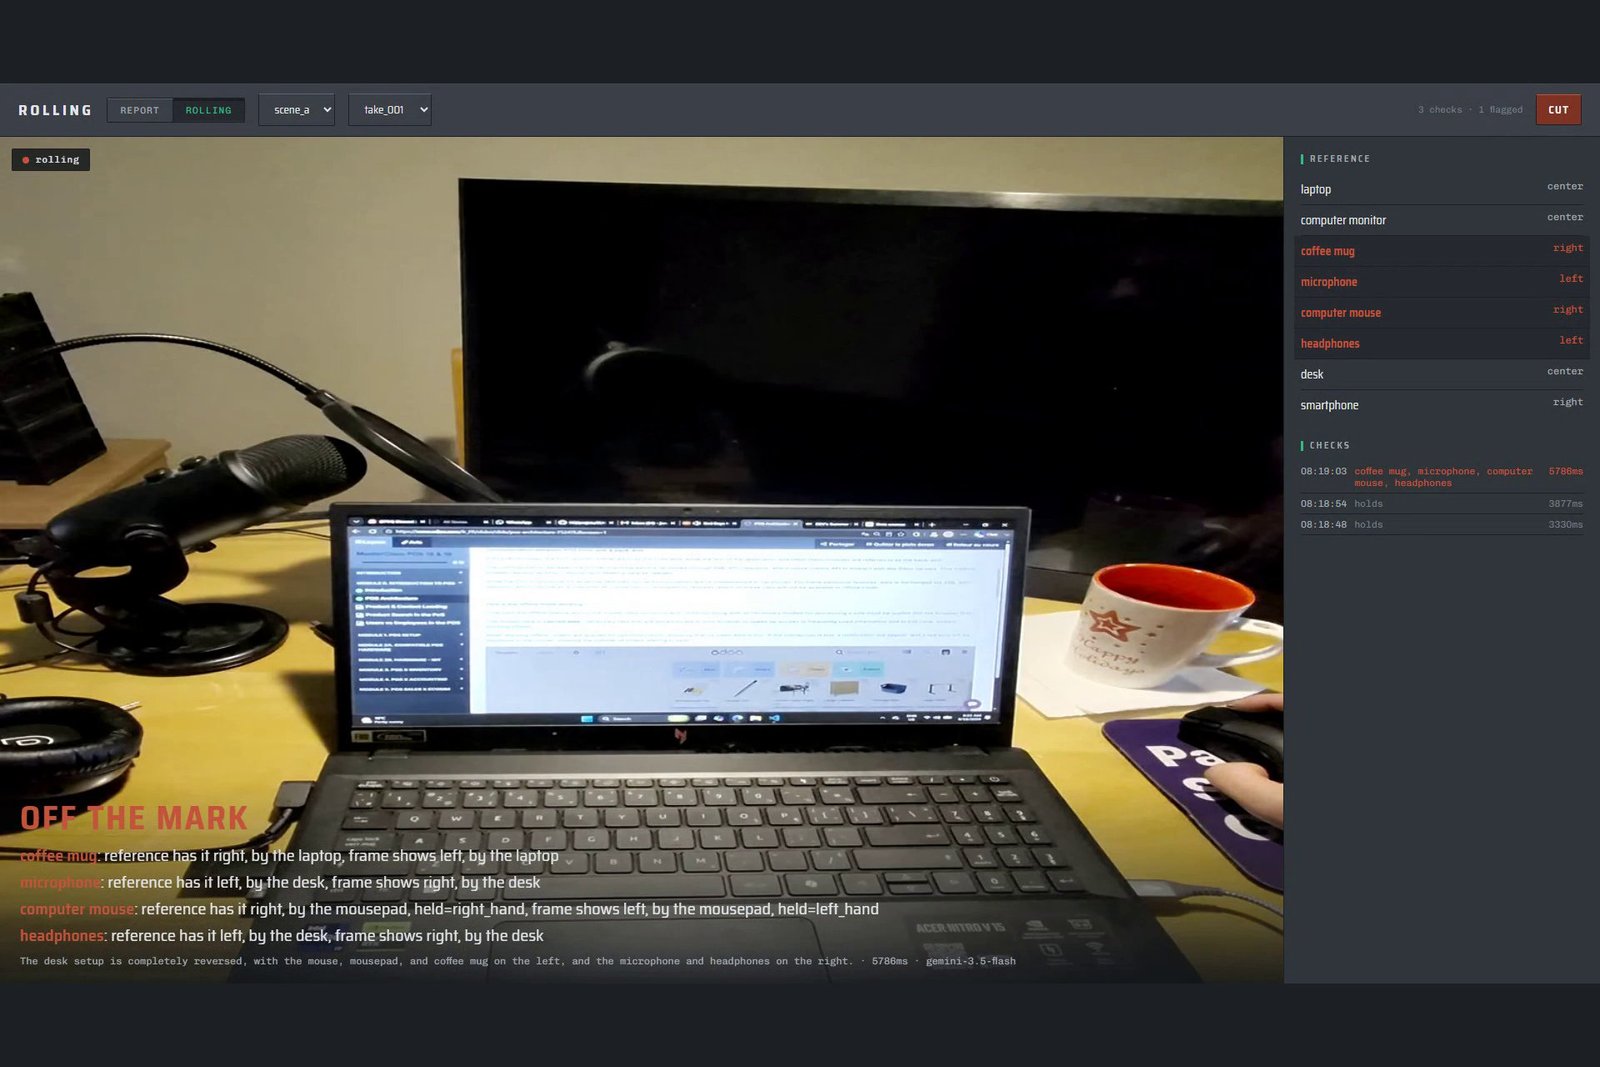
Le dernier métier sur un tournage encore fait entièrement sur papier, c'est la continuité. Manquez une ligne, découvrez-la au montage, payez un jour de reprises à 1 440 $ ou 3 020 $ (Giggster 2026). Dailies surveille une prise via des Ray-Ban Meta Gen 2 pour 1,6 cent aux tarifs Gemini publiés par Google, 63 cents une journée de quarante prises, 0,04 % de la journée qu'elle protège. Gemini lit chaque prise, ClickHouse Cloud garde les observations, et une boîte à questions en anglais simple laisse un agent écrire son propre SQL via le serveur officiel mcp-clickhouse. L'agent ne peut pas détruire de données : trois couches indépendantes, et celle qui compte est un compte cluster en lecture seule refusant DROP, INSERT, TRUNCATE, CREATE TABLE et ALTER avec le code ClickHouse 497. Le verdict médian en direct est de 4,4 secondes, prononcé dans l'oreille du porteur. Le moment clé dans la démo de 2 min 31 s tombe à 0:49.
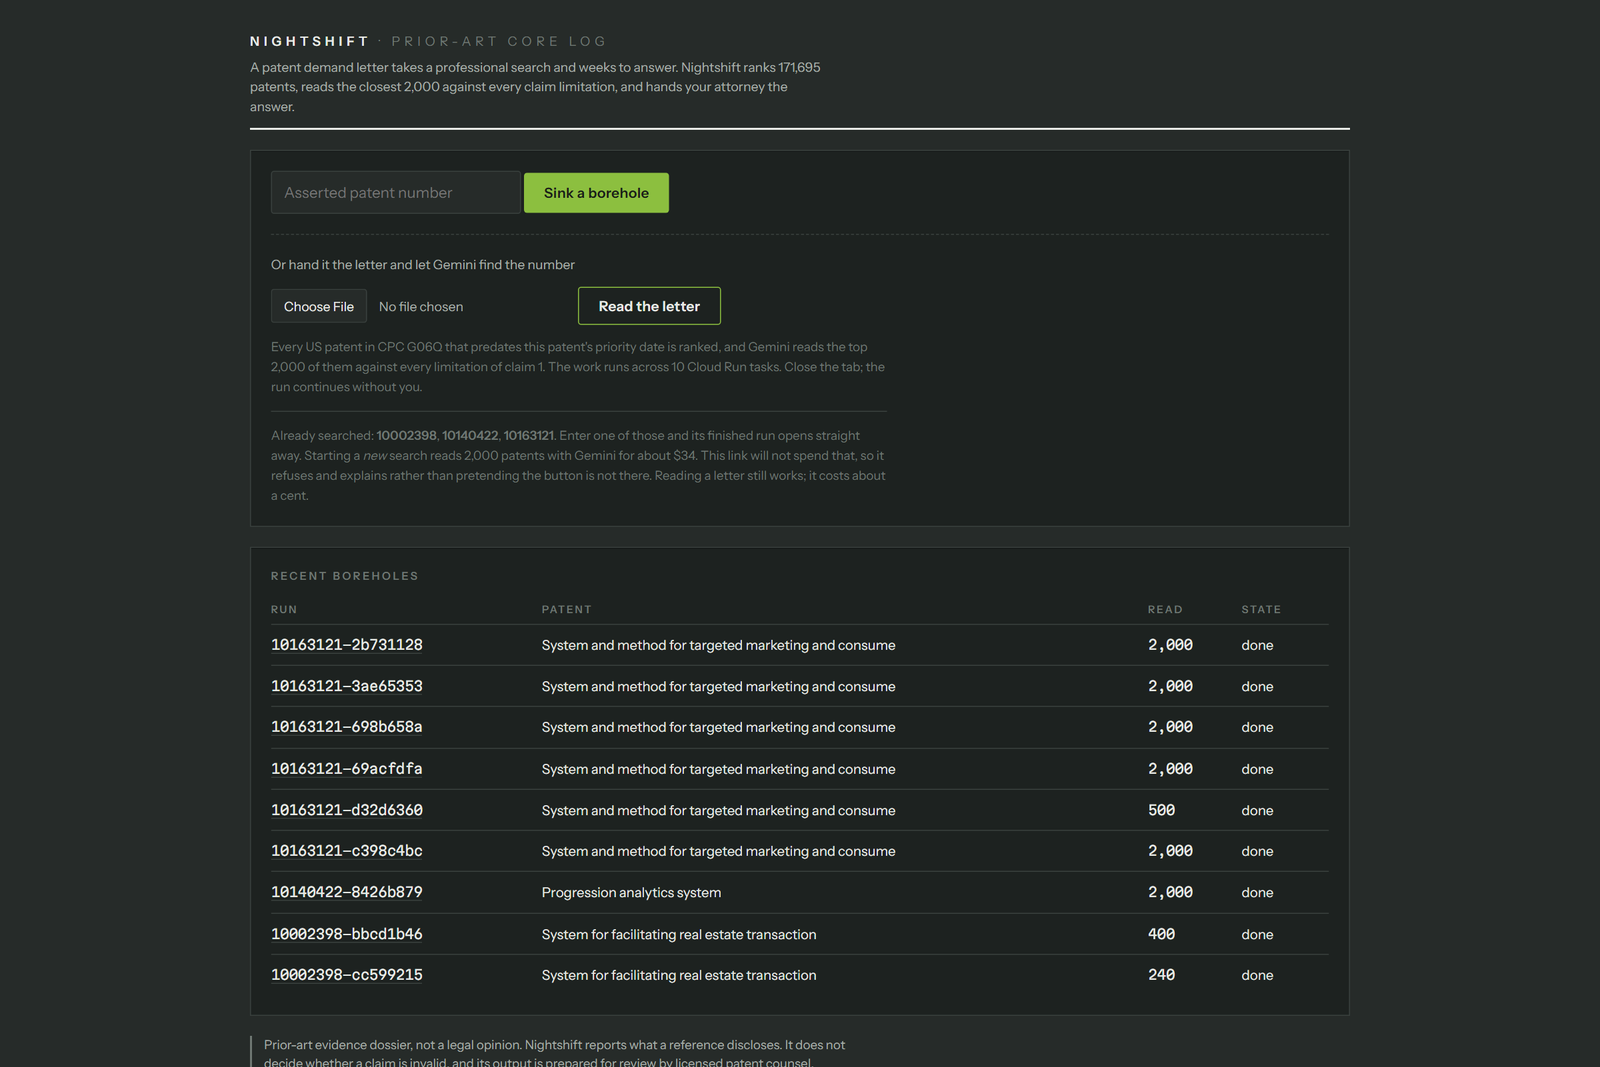
Nightshift lit 2 000 brevets en 4 minutes pour 34 $ et trouve la référence que l'examinateur a manquée
Chaque outil d'antériorité existant est un système de récupération : classer un corpus, montrer à un humain le top-quelques-dizaines. Ça a un plafond mesurable : avec le meilleur embedding disponible, un top-50 rate encore 59,7 % des références qu'un examinateur USPTO a réellement appliquées. Nightshift est un système de jugement : une passe vectorielle réduit 171 695 brevets, puis Gemini en lit deux mille, pas cinquante, décidant pour chacun s'il divulgue chaque limitation. En aveugle contre les vraies citations d'actions d'office USPTO : 97,5 % de rappel des références d'anticipation appliquées par l'examinateur (n=40), 92,5 % sur l'obviousness (n=40), 18,8 % sur un ensemble de contrôle jamais cité. Sur la démo, 4 minutes sur 10 tâches Cloud Run, 34,57 $, il a fait remonter indépendamment la référence X-cite de l'examinateur à profondeur 218, plus une référence de 1998 que l'examinateur a manquée qui enseigne six des sept limitations en propre.